作者: zhengadmin

  • Linux网络管理

    ip网络通信类型补充:

    在ipv4地址下:

    ​ ● 单播(Unicast)平时上网与服务器之间1v1双向单播

    ​ ● 广播(Broadcast) 网络广播一般是255.255.255.255或某个子网主机位全为1的网段,广播必须接收

    ​ ● 组播(Multicast) D类地址可用于组播,组播是接收方自动加入

    在ipv6地址下:

    没有广播了,只有任播(anycast)

    子网掩码补充

    如何通过子网掩码划分,将192.168.1.0/24的网络,划分成2个子网?划分成4个呢?

    先尝试将子网掩码往后移动一位

    1100 0000.1010 1000.0000 0001.0|000 0000
    1111 1111.1111 1111.1111 1111.1|000 0000  (子网掩码是255.255.255.128)
    
    # 掩码后移之后,得到新的两个网络,主机位全0代表网络号
    1100 0000.1010 1000.0000 0001.0|000 0000  (192.168.1.0/25)
    1100 0000.1010 1000.0000 0001.1|000 0000  (192.168.1.128/25)
    
    #1100 0000.1010 1000.0000 0001.10|00 0000(192.168.1.128/26)
    #1100 0000.1010 1000.0000 0001.11|00 0000(192.168.1.192/26)
    #1111 1111.1111 1111.1111 1111.11|00 0000
    
    # 广播地址为主机位全为1,因此两个网络各自的广播地址为
    1100 0000.1010 1000.0000 0001.0|111 1111  (192.168.1.127)
    1100 0000.1010 1000.0000 0001.1|111 1111  (192.168.1.255)
    
    # 各自子网可容纳的主机数
    1100 0000.1010 1000.0000 0001.0|000 0001 - 1100 0000.1010 1000.0000 0001.0|111 1110   (192.168.1.1   - 192.168.1.126)
    1100 0000.1010 1000.0000 0001.1|000 0001 - 1100 0000.1010 1000.0000 0001.1|111 1110   (192.168.1.129 - 192.168.1.254)

    得到如下表格中的信息

    子网网络地址范围广播地址
    第1个 /25192.168.1.0/250 ~ 127192.168.1.127
    第2个 /25192.168.1.128/25128 ~ 255192.168.1.255

    这样划分之后,那这两个子网内部设备不需要经过路由转发,因为在同一个局域网直接通过arp协议广播就可以找到对方;

    如果192.168.1.0/25内部的某个机器,需要与192.168.1.128/25内部的某个机器通信,就需要发给路由器了;

    那主机如何判断目标地址是否与自己在一个局域网内部呢?非常简单:目标ip&子网掩码=自己的网段 满足等式就在一个局域网,否则不在。

    ARP协议补充

    路由器arp协议寻找目标设备目标设备arp回答ipconfig /all 查看
    imgimgimg

    ==总结==:

    image-20260725135418359

    image-20260725135444503


    DHCP补充

    自己尝试一下dhcp获取ip地址,并抓取dhcp报文

    # 安装tcpdump,linux抓包工具
    yum install tcpdump
    
    # -i any 指定监听的网卡
    # -n    不解析主机名,默认情况下 tcpdump 会尝试把 IP 地址反向解析成域名
    # port 67 or port 68    过滤条件
    # 67 DHCP 服务端监听端口
    # 68 DHCP 客户端监听端口
    # -w dhcp_capture.pcap  可以使用wireshark打开
    tcpdump -i any -n port 67 or port 68 -w dhcp_capture.pcap
    
    # 新开一个shell
    # 删除保持通过dhcp获取的缓存ip信息
    cd /var/lib/NetworkManager/
    rm internal-7e7958c9-d951-3deb-af85-4459aa3dbe39-ens160.lease # 这个文件里面存放了dhcp获取的ip地址
    nmcli connection down ens160 && sudo nmcli connection up ens160

    image-20260727183344713

    自己设置ip地址

    image-20260727184714833

    抓包文件示例:dhcp_capture.pcap

    由抓包报文可以看出,dhcp基于udp协议,并且是应用层协议

    网关(路由器)(==gateway==)

    image-20260727182713963

    image-20260727182731009

    DNS域名解析补充

    ​ 1. linux中/etc/hosts也保存了主机的域名映射关系

    [root@192 ~]# cat /etc/hosts
    127.0.0.1   localhost localhost.localdomain localhost4 localhost4.localdomain4
    ::1         localhost localhost.localdomain localhost6 localhost6.localdomain6
    # 可以尝试将www.baidu.com 解析到127.0.0.1上
    
    # 此文件保存了dns服务器地址,默认是网关地址
    [root@192 ~]# cat /etc/resolv.conf
    # Generated by NetworkManager
    search localdomain
    nameserver 192.168.18.2
    # 可以尝试去掉,或者改成114.114.114.114,之后ping www.baidu.com将无法联通

    ​ 2. dns解析相关的命令

    ping www.baidu.com #可以触发dns解析
    # 需要安装bind的工具包
    yum install bind-utils
    dig www.baidu.com  #可以查看详细解析记录
    nslookup www.baidu.com  # 也可以查看详细解析记录

    ​ 3. 域名购买和配置

    ​ ● 可以去阿里云购买

    ​ ● 域名解析怎么配置

    imgimg

    配置网络参数补充

    改ip参数和dns参数

    vim /etc/NetworkManager/system-connections/ens160.nmconnection 
    [connection]
    id=ens160
    uuid=7e7958c9-d951-3deb-af85-4459aa3dbe39    
    type=ethernet
    autoconnect-priority=-999
    interface-name=ens160
    timestamp=1781681830
    
    [ethernet]                                    ← 保持不变
    
    [ipv4]
    method=manual                                  ← 🔴 改:manual
    address1=192.168.18.130/24,192.168.18.2        ← 🟢 新增
    dns=192.168.18.2;114.114.114.114               ← 🟢 新增
    
    [ipv6]
    addr-gen-mode=eui64
    method=ignore                                
    
    [proxy]          
    
    #使用nmcli重新刷新配置并重启网卡
    nmcli conn reload # 重载配置
    nmcli conn down ens160  # 断开连接
    nmcli conn up ens160  # 重新连接                       

    ​ 4. 为了便于使用常常的nmcli命令,我们可以安装bash提示包,之后使用tab可以获取命令提示

    dnf install -y bash-completion
    source /etc/profile.d/bash_completion.sh# 或者关闭终端重新进入

    ​ 5. 如果想让网卡物理断开,请使用ip link

    # 直接拔掉网卡的“电源”
    ip link set ens160 down 

    ​ 6. nmcli/nmtui和network以及ens160物理网卡之间的关系

      用户 
       │
       ▼ 发出指令 (例如: nmcli conn up ens160)
     控制器 [ nmcli / nmtui ]
       │
       ▼ 
     管理者 [ NetworkManager 服务 (后台进程) ]
       │
       ▼ 擦除/写入 IP,开启/关闭状态
     Linux 系统内核 (Kernel) ───► 看到的效果就是 [ ip a ] 里的状态变化
       │
       ▼
     物理/虚拟网卡硬件 (ens160)
    
    [root@localhost ~]# systemctl stop NetworkManager
    [root@localhost ~]# nmcli conn down ens160
    错误:网络管理器(NetworkManager)未运行。
    [root@localhost ~]#

    image-20260727210514621

    ==注意==: 只要Networkmanager中断了,nmcli程序就用不了

    ​ 7. nmcli命令中的up详解

    [root@localhost ~]# nmcli connection add type ethernet ifname ens160 con-name dhcp_ens160   # con-name不作为唯一id,uuid是唯一区分的key
    连接 "dhcp_ens160" (91641ede-2ff8-419f-84c9-09be1de79c78) 已成功添加。
    [root@localhost ~]# nmcli conn show
    NAME         UUID                                  TYPE      DEVICE
    ens160       7e7958c9-d951-3deb-af85-4459aa3dbe39  ethernet  ens160
    有线连接 1   80fc7e2a-c7ac-3604-939b-3cef2431af69  ethernet  ens224
    lo           4627f296-ae4f-43c9-9b77-b8929460b955  loopback  lo
    dhcp_ens160  721ec306-fde4-496c-9687-07e11a896b63  ethernet  --
    [root@localhost ~]# nmcli conn up 721ec306-fde4-496c-9687-07e11a896b63
    连接已成功激活(D-Bus 活动路径:/org/freedesktop/NetworkManager/ActiveConnection/4)
    [root@localhost ~]# ip a
    1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN group default qlen 1000
        link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
        inet 127.0.0.1/8 scope host lo
           valid_lft forever preferred_lft forever
        inet6 ::1/128 scope host
           valid_lft forever preferred_lft forever
    2: ens160: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc mq state UP group default qlen 1000
        link/ether 00:0c:29:14:8e:67 brd ff:ff:ff:ff:ff:ff
        altname enp3s0
        inet 192.168.18.129/24 brd 192.168.18.255 scope global dynamic noprefixroute ens160
           valid_lft 1797sec preferred_lft 1797sec
        inet6 fe80::5eb6:76ae:6991:2649/64 scope link noprefixroute
           valid_lft forever preferred_lft forever
    3: ens224: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc mq state UP group default qlen 1000
        link/ether 00:0c:29:14:8e:71 brd ff:ff:ff:ff:ff:ff
        altname enp19s0
        inet 192.168.199.128/24 brd 192.168.199.255 scope global dynamic noprefixroute ens224
           valid_lft 1735sec preferred_lft 1735sec
        inet6 fe80::632c:8843:174f:955a/64 scope link noprefixroute
           valid_lft forever preferred_lft forever
    
    [root@localhost ~]# nmcli connection delete dhcp_ens160 
    成功删除连接 "dhcp_ens160" (721ec306-fde4-496c-9687-07e11a896b63)。

    ==总结==:

    image-20260727135726435

    image-20260727135747155


    ​ 8. MTU三层网络层数据包最大传输单元,MTU限定单IP包体积。过大丢包/分片,过小浪费带宽


    网络基础知识

    OSI七层模型

    img

    OSI是理论标准,TCP/IP是事实标准,五层是工程和教学的折中,更常用。每一层的唯一标识如下

    数据链路层——MAC地址

    网络层——IP地址传输层——端口号应用层——PID

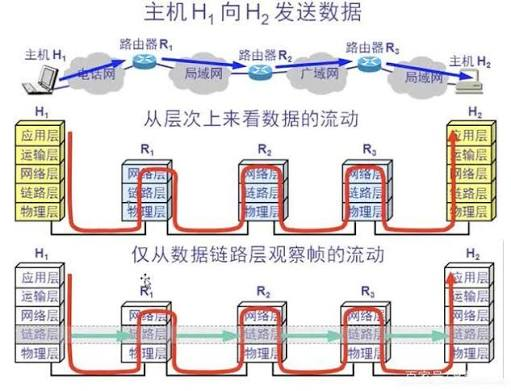
    一个就简单路由器过程示例

    img

    img

    数据包流转每一层所干的事情

    img

    网络分层动图

    1703522738665.gif

    img

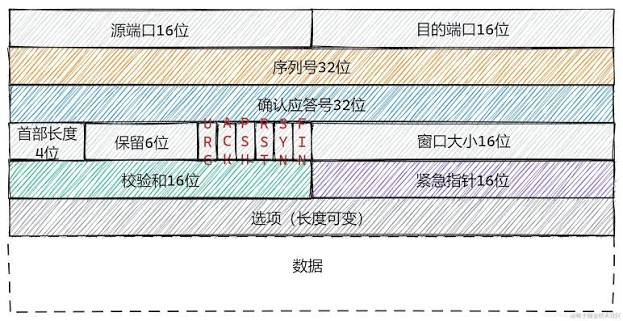
    tcp报文格式

    imgimg

    使用wireshark抓取tcp数据包分析一下,按照报文格式,理解大端字节序和小端字节序。

    由此可见,什么是网络协议工程师

    image-20260728192507699

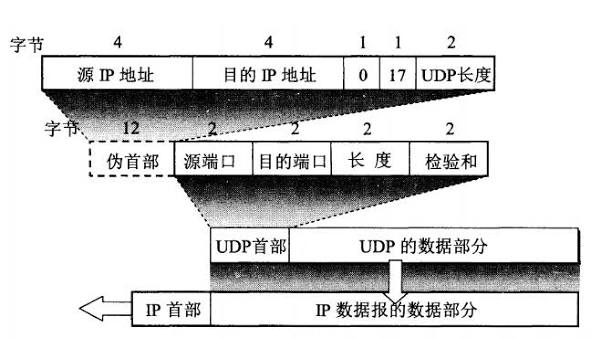
    udp和tcp对比

    img

    对比维度TCPUDP
    连接状态面向连接(需三次握手建立链路)无连接(直接发送,无需握手)
    可靠性高(确认机制、超时重传、校验和)低(只做基础校验,丢包不重传)
    数据顺序保证有序(按字节流编号,乱序重组)不保证(先发的可能后到,应用层自己处理)
    流量/拥塞控制有(根据网络状况动态调整发送速度)无(发得快不快,完全看应用层,网络堵了照发)
    传输效率较低(头部开销大,20字节,且需维护状态)极高(头部仅8字节,处理简单)
    收发模式全双工(可同时收发)支持一对一、一对多、多对多(广播/组播)
    适用场景文件传输、网页浏览、邮件、数据库实时音视频、直播、在线游戏、DNS查询

    ==总结==:

    关键点:

    • TCP 把数据看成连续的字节流,没有”消息边界”
    • 你发 3 次(100+200+50),接收端可以 1 次收完 350 字节
    • 也可以分 10 次收,每次收一部分
    • 发多少次 ≠ 收多少次

    关键点:

    • UDP 保留应用层发送的完整报文边界
    • 发 3 次,收 3 次,一一对应
    • 一次 recvfrom 只能读到一个完整报文
    • 如果接收缓冲区小于报文大小,多余数据会被丢弃

    ==粘包与拆包==:

    TCP “粘包” 问题详解

    什么是粘包?

    text

    发送端发了 3 次:
    第一次: "Hello"
    第二次: "World"
    第三次: "!"
    
    接收端 recv 一次读到: "HelloWorld!"

    3 次发送,1 次收到,数据粘在一起了 → 粘包

    还有”拆包”

    text

    发送端发一次: "HelloWorld!"
    接收端 recv 两次:
    第一次读到: "Hello"
    第二次读到: "World!"

    1 次发送,多次收到 → 拆包

    统称”粘包/拆包问题”

    本质原因:TCP 是流式协议,没有消息边界。

    解决方案(应用层自己定边界)

    方案 实现方式 示例
    固定长度 每个消息固定大小 每次发 1024 字节,不足补 0
    分隔符 用特殊字符分隔 如 HTTP 用 rnrn,用 n
    长度字段 消息头带长度 4 字节头 + 变长 body(最常用)

    tcp三次握手

    img

    tcp四次挥手

    img


    传输层状态查看相关命令

    端口号

    内核在传递网络数据包过程中,定位进程的唯一标识就是就口号,所以如果是网络服务程序,启动时必须绑定一个固定的端口号。

    启动一个python server,默认端口使用了5000,也就意味着,当客户端使用curl http://192.168.18.129:5000,http应用层数据包达到linux系统后,操作系统会首先寻找监听在5000端口的应用程序,如果没有直接丢弃。如果有,再去查询绑定ip,如果进程绑定的是0.0.0.0包含所有ip,内核就将数据包交给他。如果进程绑定的是精确的ip,例如192.168.18.129,也可交个他。如果数据包目的ip与绑定的不同,丢弃。

    # 指定具体的ip和端口号
    [root@localhost ~]# python3.14 -m http.server -b 192.168.18.129 8080
    Serving HTTP on 192.168.18.129 port 8080 (http://192.168.18.129:8080/)
    
    # 默认启动一个server
    [root@localhost ~]# python3.14 -m http.server
    Serving HTTP on 0.0.0.0 port 8000 (http://0.0.0.0:8000/) ...
    端口号理解

    端口号本质上是操作系统分配给网络进程的唯一标识。当数据包通过IP地址到达你的电脑后,操作系统需要根据“端口号”来决定把数据交给哪个应用程序。

    • 如果端口上有程序在监听(处于 LISTENING 状态),操作系统就会把数据复制给该进程。
    • 如果端口上没有程序监听,操作系统会认为没有应用需要这份数据,直接丢弃数据包,并向发送方回复一个 ICMP(互联网控制报文协议)不可达 或 RST(重置连接) 报文,表示“连接被拒绝”。

    如果一个端口已经被进程 A 监听,那么进程 B 再想监听同一个端口(特别是 TCP)会报错 “Address already in use”。这保证了端口与进程的一一对应关系,也印证了“端口必须有程序监听”这一规则。

    ==–bind 0.0.0.0 就是你说的”通配符无论哪张网卡都会处理”,任何 IP 访问这个端口都能响应。==

    最简方式:http.server 模块

    1. 基本启动

    bash

    # 默认端口 8000,绑定所有网卡
    python3 -m http.server
    
    # 指定端口
    python3 -m http.server 8080
    
    # 指定绑定地址(0.0.0.0 表示所有网卡)
    python3 -m http.server 8080 --bind 0.0.0.0

    --bind 0.0.0.0 就是你说的”通配符无论哪张网卡都会处理”,任何 IP 访问这个端口都能响应。

    2. 指定目录

    bash

    # 把 /var/www/html 作为根目录
    python3 -m http.server 8080 --bind 0.0.0.0 --directory /var/www/html

    3. 浏览器访问

    text

    http://192.168.1.100:8080/
    http://127.0.0.1:8080/
    http://localhost:8080/

    五、技术选型的取舍(Nginx 大而全 vs Python 小而轻)

    • Nginx 多进程:在高并发场景下利用多核,进程数量多,资源占用高,配置复杂,适合生产级基础设施。
    • Python http.server / 自写代理:单进程/单线程,性能有限,但极轻量。当业务简单(如内部调试、单点中转)且不希望被复杂的 Nginx 配置和进程管理干扰时,Python 直写是快速验证思想的最佳方案。
    • 核心:脱离场景谈技术没有意义。复杂业务用 Nginx,快速验证或轻量级定制用 Python,这是工程取舍的智慧。

    tcp还有重传,流量控制,滑动窗口,拥塞控制等机制,理论巨多,大家可以自行拓展,看看计算机网络相关数据

    常用端口号

    22(SSH)、80/443(HTTP/HTTPS)、3306(MySQL)、6379(Redis)、53(DNS)

    网络相关命令

    ### ss(替代 netstat)
    # -a, --all           display all sockets
    # -l, --listening     display listening sockets
    # -t, --tcp           display only TCP sockets
    # -u, --udp           display only UDP sockets
    # -p, --processes     show process using socket
    ss -tlnp      # TCP 监听端口 + 进程名
    ss -tulnp     # TCP+UDP 监听
    
    [root@localhost ~]# ss -tlnp
    State            Recv-Q           Send-Q                     Local Address:Port                     Peer Address:Port           Process
    LISTEN           0                128                              0.0.0.0:22                            0.0.0.0:*               users:(("sshd",pid=927,fd=3))
    LISTEN           0                128                                 [::]:22                               [::]:*               users:(("sshd",pid=927,fd=4))
    
    # 统计摘要
    [root@localhost ~]# ss -s
    Total: 131
    TCP:   8 (estab 6, closed 0, orphaned 0, timewait 0)
    
    Transport Total     IP        IPv6
    RAW       2         0         2
    UDP       4         3         1
    TCP       8         7         1
    INET      14        10        4
    FRAG      0         0         0
    
    # lsof
    # -i select IPv[46] files, 读取ip相关的运行时文件
    lsof -i :8080       # 谁在用 8080
    lsof -i tcp:3306    # MySQL 谁在监听
    
  • Linux文件名后缀

    Linux 文件后缀命名规则总结


    核心规律:有 d = 服务端守护进程,无 d = 客户端

    后缀类型含义典型示例
    xxxd守护进程(Daemon) 服务端程序,后台持续运行sshd、httpd、mysqld、crond、nfsd、vsftpd、dhcpd
    xxx(无后缀)客户端程序 用户主动执行的命令工具ssh、mysql、ftp、ping、curl、wget

    配置文件相关后缀

    后缀 含义 典型示例
    xxx_config 配置文件(明确命名) ssh_config(客户端)、sshd_config(服务端)
    xxx.conf 配置文件(传统风格) httpd.conf、nginx.conf、resolv.conf、yum.conf
    .xxxrc 运行命令配置(Run Command) .bashrc、.vimrc、.zshrc
    xxx.ini 初始化配置文件 php.ini、my.ini(Windows 风格)

    系统运行时文件后缀

    后缀 含义 典型示例
    xxx.pid 进程 ID 文件(记录进程号) /var/run/sshd.pid、/var/run/nginx.pid
    xxx.lock 锁文件(防止重复运行) /var/run/yum.pid、/var/lock/subsys/
    xxx.sock 套接字文件(进程间通信) /var/run/docker.sock、/tmp/mysql.sock
    xxx.log 日志文件 /var/log/messages、/var/log/secure

    编程相关文件后缀

    后缀 含义 典型示例
    .sh Shell 脚本 install.sh、start.sh
    .py Python 脚本 app.py、manage.py
    .pl Perl 脚本 script.pl
    .rb Ruby 脚本 app.rb
    .js JavaScript 文件 app.js
    .json JSON数据文件 package.json、config.json
    .yaml/.yml YAML 配置文件 docker-compose.yml、k8s-deploy.yaml
    .xml XML 配置文件 web.xml、pom.xml
    .toml TOML配置文件 Cargo.toml、pyproject.toml

    压缩包/归档文件后缀

    后缀 含义 常用命令
    .tar 归档文件(未压缩) tar -cf
    .tar.gz/.tgz tar + gzip 压缩 tar -zxf
    .tar.bz2 tar +bzip2 压缩 tar -jxf
    .tar.xz tar + xz 压缩 tar -Jxf
    .zip ZIP 压缩包 unzip
    .gz gzip 压缩文件 gunzip
    .bz2 bzip2压缩文件 bunzip2
    .xz xz 压缩文件 unxz

    软件包后缀(不同发行版)

    后缀 含义 对应发行版
    .rpm Red Hat 包管理器 RHEL、CentOS、Rocky、Fedora
    .deb Debian包管理器 Debian、Ubuntu、Linux Mint
    .apk Alpine 包管理器 Alpine Linux
    .pkg 通用安装包 macOS、Solaris 等

    设备/特殊文件(不重要)

    后缀 含义 典型示例
    .ko 内核模块(Kernel Object) /lib/modules/*.ko
    .so 动态链接库(Shared Object) libc.so.6、libssl.so
    .a 静态库(Archive) libc.a
    .o 目标文件(Object file) main.o(编译中间产物)

    记忆口诀

    text

    有 d 是服务端,没 d 是客户端
    conf 是配置,rc 是运行
    pid 记进程,lock 防重入
    sock 管通信,log 记日志
    压缩看后缀,包看发行版

    特别注意: Linux 文件的后缀名对系统本身没有强制意义(不同于 Windows),它更多是给人看的约定,方便识别文件类型。系统实际通过 file 命令读取文件头来判断类型。

  • Python并发编程

    基础概念

    CPU密集型和IO密集型

    cpu密集型任务的特点是:持续使用cpu,持续不断的运行。例如压缩与解压,代码编译,视频编解码等。这些任务只要开始,cpu占用曲线就居高不下。

    IO密集型任务特点是:大量时间用于等待,cpu处理时间少。例如用户输入,文件I/O,网络I/O,数据库I/O等。cpu占用曲线很低,偶尔有尖峰。

    那如何解决这个问题?

    并发和并行

    并发是物理上一个cpu交替做,一个cpu通过控制执行时间即可做到(时间片轮转算法)

    比如咖啡店做咖啡,一个咖啡机,轮流做拿铁,卡布奇诺,美式,对于客户来说,看起来几乎在同时处理

    并行是物理上多个cpu同时做,因此必须多核CPU才能实现并行

    比如咖啡店做咖啡,3台机器,分别做拿铁,卡布奇诺,美式,互不干扰,同时完成

    image-20260608074750199

    进程到底有哪些东西构成?线程有哪些东西构成?

    进程在操作系统内核角度的描述

    组成部分 内容
    pid 进程唯一编号
    进程状态 就绪,运行,阻塞
    程序计数器(pc) 执行到哪条指令了
    代码段 程序的指令
    数据段 全局变量、静态变量
    堆 动态分配的对象(malloc)
    栈 函数调用链 + 局部变量
    文件描述符表(fd) 打开的文件和网络连接file:[0,1,2,3],标准输入,标准输出和标准错误是哪几个文件描述符

    线程相较于进程独立的东西(TID,pc,线程状态,栈区)剩下的数据段,代码段,堆等都与进程共享。

    在 Linux 内核的代码里,其实根本没有线程这个数据结构。无论是进程还是线程,在内核中都叫“任务”(Task),都用task_struct结构体来表示。

    那进程和线程的区别体现在哪?—— 体现在“共享资源的多少”上。

    可以把 task_struct理解为一张“任务身份证”,每个执行流都有一张。区别在于:

    一个进程(通常指只有主线程的情况):这张身份证指向的所有资源(内存、文件等)都是独占的。

    一个线程:这张身份证指向的资源,大部分和同组的其他身份证共享

    这就是为什么 Linux 的线程被称为轻量级进程的原因创建线程时,内核不需要像创建进程那样复制一大堆资源,只需要新建一个 task_struct,然后让它指向现有资源即可。

    根本区别:操作系统资源分配的最小单位是进程,CPU独立调度和执行的最小单位是线程。

    共享关系:进程间内存相互独立,不可直接访问;同一进程下的线程,共享该进程的堆,文件等资源。

    切换开销:进程更大,线程更小,只要保存少量寄存器和栈信息。

    进程转换状态图

    见课件部分,核心三态,补充两态

    线程和进程一样

    就绪缺的是cpu时间,阻塞缺的是某个资源或者事件(磁盘,网络,用户输入)

    image-20260608210122054

    同步和异步、阻塞与非阻塞

    概念 描述的对象 描述的是什么 例子
    阻塞/非阻塞 调用者(线程/进程)的状态 调用者在等待结果时,自己还能不能干别的事 (阻塞)站在排队队伍里,不能刷手机,不能看书,整个人处于“石化”和等待状态,只能干等。(非阻塞)在等餐时,你一直在刷手机、背单词或者和同学聊天。虽然你还在等,但你并没有被“冻结”,然后自己轮询看看好没好(polling)
    同步/异步 被调用者(任务/IO,通常是函数)的通知方式 任务完成时,是主动通知调用者,还是需要调用者主动去问 (同步)你在打饭窗口点了小笼包,阿姨正在蒸。你就在窗口一直盯着阿姨,直到阿姨把小笼包递给你,你才离开(异步) 你在取餐窗口点了黄焖鸡,阿姨给了你一个会震动的取餐号牌(回调机制)。你拿到号牌就可以离开窗口了,等黄焖鸡好了,号牌一震动,你再去取

    阻塞/非阻塞 = 我(调用者)还能不能动

    同步/异步 = 它(被调用者)会不会叫我

    排列组合

    组合 调用者状态 通知方式
    同步阻塞 等结果时不能动 调用者主动等
    同步非阻塞 立即返回,但要轮询 调用者主动问
    异步(非阻塞) 立即返回,不用轮询 被调用者主动通知(回调)

    ==总结==:

    现代操作系统运行程序时,基本都是以并发方式进行的。这里的“并发”指的是在宏观上多个程序同时向前推进,但在微观(单核 CPU)上其实是交替执行,每个时刻只有一个程序占用 CPU。

    为了更精确地说明,有必要区分两个概念:

    • 并发:多个任务在同一个时间段内交替执行(逻辑上同时)。单核 CPU 通过时间片轮转实现并发。
    • 并行:多个任务在同一时刻同时执行(物理上同时)。只有多核 / 多 CPU 才能实现真正并行。

    为什么操作系统运行程序基本都是并发的?

    1. CPU 数量有限 即使是普通的多核 CPU(例如 8 核),同时运行的线程数往往远超 8 个。操作系统必须通过时分复用让所有线程都有机会运行。
    2. 提高资源利用率 一个程序等待 I/O(磁盘、网络、键盘)时,CPU 会空闲。并发调度允许此时运行另一个程序,避免 CPU 空转。
    3. 用户交互需求 现代操作系统需要同时响应鼠标、键盘、网络包、后台任务等,必须用并发来提供流畅体验(例如边听歌边写文档)。
    4. 进程 / 线程模型本身就是为并发设计的 操作系统提供进程、线程作为基本执行单元,调度器负责在它们之间快速切换(通常每秒数十到数千次),宏观上就像“同时运行”。

    并发是如何实现的

    ​ 核心机制是抢占式多任务(现代操作系统普遍采用):

    ​ 时间片轮转:每个线程获得一个很短的 CPU 时间片(通常 10~100 ms)。时间片用完或主动阻塞(如 sleep、wait I/O)时,触发调 度。

    ​ 时钟中断:硬件定时器周期性中断 CPU,强制剥夺当前线程,并交由调度器选择下一个线程。

    ​ 优先级调度:重要任务(如实时音频)可抢占普通任务的 CPU 时间。

    ​ 这样,即使你只打开了一个文本编辑器,后台依然有数十个系统服务、驱动程序、守护进程在并发执行。


    ​ 并发 ≠ 并行 单核时代:严格并发(交替执行),没有真正意义的并行。

    多核时代:可以同时存在并发 + 并行。 例如 4 核 CPU 上运行 100 个线程:同一时刻有 4 个线程在并行运行,整体上仍然是 100 个线程并发运行。

    面试题

    一、同步非阻塞 vs 异步回调 核心对比

    维度 同步非阻塞 异步回调
    操作完成通知方式 调用方主动轮询 系统自动调用回调
    CPU开销 有轮询开销(可结合epoll优化) 无轮询开销
    典型代表 epoll + 非阻塞socket(Reactor) Node.js、io_uring(Proactor)
    适用场景 活跃连接数可控、需精细控制 极高并发、突发流量、长尾敏感

    二、关键追问答案

    1. 谁性能更好? 理论异步更优,但实际epoll(同步非阻塞)已足够高效。极高IOPS下io_uring(真正异步)胜出。
    2. epoll是同步非阻塞还是异步? 同步非阻塞。事件就绪后需应用主动调用read/write完成I/O。
    3. 如何解决回调地狱? Promise链式调用 → async/await语法糖(本质仍基于回调,但扁平化)。
    4. 工作中如何选?
      • 高性能中间件(网关、代理)→ 同步非阻塞+epoll(如Nginx)
      • 业务密集型应用 → 异步回调+async/await(如Node.js、Pythonasyncio)
      • 低并发简单场景 → 同步阻塞最省事

    三、面试结语(核心结论)

    同步非阻塞需要应用主动轮询或依赖事件通知,实际读写由用户线程完成,属于同步范畴;异步回调由系统/线程池完成后反向通知应用,属于异步范畴。 现代开发中,异步回调配合async/await是主流范式,但同步非阻塞(Reactor)在底层基础库中仍广泛使用。


    python多进程

    1. 进程创建和基础结构

    进程核心方法:

    start——启动进程

    join——主进程等待子进程终止。默认主进程会自动等待所有子进程结束才会退出

    ​ os. getpid( )——获取进程id

    os.getppid()——获取父进程id

    import os
    from multiprocessing import Process
    from time import sleep
    
    def func(name):
        print(f"以子进程方式运行{name}")
        print(f"子进程进程号={os.getpid()}")
        print(f"子进程中父进程进程号={os.getppid()}")
        sleep(10)
    
    # linux/mac系统是fork机制,windows用的是spawn机制,子进程为了获取代码,必须把Python文件从头导入一边
    if __name__ == "__main__":
        p = Process(target=func, args=("test",))  # 单元素元组需要加,否则和字符串混淆了
        p.start()  # 一定用start才能开启新进程,run只是在当前线程直接运行函数
        # p.join()   # 等待子进程结束
        print(f"父进程进程号={os.getpid()}")
        print("主进程运行结束")
    

    image-20260609102004707

    image-20260609102114400

    image-20260609102552247

    2. 多进程同时创建

    import time
    from multiprocessing import Process 
    
    def func(name): 
        print("hello %s" % name)
        time.sleep(1)
    
    if __name__ == "__main__":
        for i in range(20):
            p = Process(target=func, args=(f"{i}",))
            p.start()
            # p.join()  # 如果在每个start之后,都join等待子进程,便可以保证顺序运行,但是,这无法发挥多进程优势
        print("主程序结束,等待子进程....")  # 运行结果发现,进程调度确实不是顺序的,由操作系统自己决定
    

    image-20260609105708390

    3. 跟随进程

    随着主进程结束,子进程就被立即强行终止,因此此类进程并不保证里面的任务能跑完。只要主进程代码执行完,daemon=True的子进程立即杀死。

    import time
    from multiprocessing import Process
    
    
    def foo():
        print(123)
        time.sleep(1)
        print("end123")  # 父进程代码执行结束,所以这里不会输出
    
    
    def bar():
        print(456)
        time.sleep(3)
        print("end456")
    
    
    if __name__ == "__main__":
        p1 = Process(target=foo, daemon=True)  #设置为跟随,主进程退出,p1立即被强制终止
        p2 = Process(target=bar)
        p1.start()
        p2.start()
        time.sleep(0.1)
        print("main-------")

    适合心跳、日志刷写这种丢了也没啥事的任务

    操作系统中的守护进程不是python中的这个含义,可以去检索一下,linux操作系统守护进程如何创建,如何查询,如何关闭

    4. 进程间通信(IPC)

    Value共享

    from multiprocessing import Process, Value
    
    def increment(num):
        num.value += 1
        print(num.value)
    
    if __name__ == "__main__":
        counter = Value("i", 0)  # 'i' 表示整数类型
        processes = [Process(target=increment, args=(counter,)) for _ in range(30)]
        for p in processes:
            p.start()
        for p in processes:
            p.join()
    # 每次执行的结果都会不一样

    Array共享

    from multiprocessing import Array, Process
    
    def increment(arr):
        for i in range(len(arr)):
            arr[i] += 1
        print(arr[:])
    
    if __name__ == "__main__":
        arr = Array("i", [0, 0, 0])  # 'i' 表示整数类型
        processes = [Process(target=increment, args=(arr,)) for _ in range(30)]
        for p in processes:
            p.start()
        for p in processes:
            p.join()

    5. 进程间同步

    ​ 1. 互斥锁——Lock

    from multiprocessing import Lock, Process, Value
    
    def increment(num, lock):
        lock.acquire()
        num.value += 1
        print(num.value)
        lock.release()
    # 使用with可以简化,自动获取和释放锁
    # def increment(num, lock):
    #     with lock:
    #         num.value += 1
    #         print(num.value)
    
    if __name__ == "__main__":
        lock = Lock()
        counter = Value("i", 0)  # 'i' 表示整数类型
        processes = [Process(target=increment, args=(counter, lock)) for _ in range(30)]
        for p in processes:
            p.start()
        for p in processes:
            p.join()
    

    ​ 2. 信号量

    from multiprocessing import Process, Semaphore, Value
    
    def increment(num, sem):
        # 1. 尝试获取信号量(拿钥匙),如果没有钥匙了,进程会在这里阻塞等待
        sem.acquire()
    
        try:
            # 2. 核心临界区:此时只有一个进程能进入这里,安全地修改数据
            num.value += 1
            print(num.value)
        finally:
            # 3. 无论如何,执行完后必须释放信号量(还钥匙),否则后面的进程会永远死锁
            sem.release()
    
    
    if __name__ == "__main__":
        counter = Value("i", 0)  # 共享变量
    
        # 创建一个容量为 1 的信号量(相当于互斥锁,同一时间只允许 1 个进程访问)
        sem = Semaphore(1)
    
        # 将信号量 sem 作为参数传给子进程
        processes = [Process(target=increment, args=(counter, sem)) for _ in range(30)]
    
        for p in processes:
            p.start()
        for p in processes:
            p.join()
    
        print(f"最终结果: {counter.value}")  # 必定雷打不动输出 30

    image-20260611110518099


    ==总结==:

    image-20260609154902633

    image-20260609155020628


    image-20260609160146959


    6. IPC-Manager对象

    from multiprocessing import Manager, Process
    
    def update_dict(shared_dict):
        shared_dict["common"] = shared_dict["common"] + 1
        print(shared_dict)
    
    if __name__ == "__main__":
        with Manager() as manager:
            shared_dict = manager.dict()
            shared_dict["common"] = 0
            processes = [
                Process(target=update_dict, args=(shared_dict,)) for _ in range(30)
            ]
            for p in processes:
                p.start()
            for p in processes:
                p.join()

    image-20260610214147267


    7. IPC-Pipe管道

    TODO:linux开发中,c语言调用linux系统api创建的管道怎么做的

    from multiprocessing import Pipe
    
    conn1, conn2 = Pipe()
    conn1.send("Hello")
    print(conn2.recv())
    conn2.send("World")
    print(conn1.recv())

    image-20260610222005990

    image-20260610222459304


    8. IPC-队列

    队列的特点是是先进先出FIFO,multiprocessing.Queue是Python中线程安全的阻塞队列,能自动避免数据竞争问题(消息队列)

    import queue
    from multiprocessing import Queue
    
    q = Queue(3)
    
    q.put("1")
    q.put("2")
    q.put("3")
    # q.put(3)  # 队列已满,put被阻塞
    
    try:
        q.put_nowait("4")  # 非阻塞方式:但会抛出异常
    except queue.Full:
        print("队列已经满了")
    
    print(q.full())
    print(q.get())
    print(q.get())
    print(q.get())
    print(q.get())  # 队列已空,get被阻塞

    生成这消费者模型,生产环境手动使用这些api很少,一般直接使用中间件,消息队列,比如RabbitMQ和Kafka.这些中间件提供了消息不丢失,持久化等开箱即用功能。

    在linux操作系统中,进程间通信有哪些方式?

    image-20260611093229685

    image-20260611093330731

    image-20260611093422146

    ==总结==:

    image-20260611094215677

    image-20260611094411837

    9. 进程池

    ​ 1. 同步执行

    因为阻塞知道任务完成,所以多个任务串行,适合需要保证顺序的场景

    from multiprocessing import Pool
    import time
    
    def worker(n):
        """模拟耗时任务"""
        time.sleep(n)
        return f"任务 {n} 完成"
    
    if __name__ == '__main__':
        with Pool(4) as pool:
            print("开始执行...")
    
            # 同步执行,会阻塞直到完成
            result = pool.apply(worker, (2,))
            print(f"结果: {result}")  # 2秒后才输出

    ​ 2. 异步执行

    apply_async立即返回,任务在后台执行,不阻塞主进程

    from multiprocessing import Pool
    import time
    
    def worker(n):
        time.sleep(n)
        return f"任务 {n}"
    
    if __name__ == '__main__':
        with Pool(4) as pool:
            # 提交多个异步任务
            results = []
            for i in range(5, 0, -1):
                result = pool.apply_async(worker, (i,))
                results.append(result)
                print(f"已提交任务 {i}")
    
            # 收集所有结果
            for i, result in enumerate(results):
                print(f"获取结果 {i+1}: {result.get()}")

    异步的回调写法

    import time
    from multiprocessing import Pool
    
    def worker(n):
        time.sleep(n)
        return n * 2
    
    def callback(result):
        """成功时的回调函数"""
        print(f"任务完成,结果: {result}")
    
    
    def error_callback(error):
        """失败时的回调函数"""
        print(f"任务失败: {error}")
    
    
    if __name__ == "__main__":
        with Pool(4) as pool:
            # 添加回调函数
            result = pool.apply_async(
                worker, args=(2,), callback=callback, error_callback=error_callback
            )
    
            # 主进程可以继续做其他事
            print("主进程继续执行...")
    
            # 确保所有任务完成
            result.wait()

    image-20260611125932897

    image-20260611130425061


    python多线程

    全局解释器锁GIL

    英文全称Global Interpreter Lock。CPython(官方 Python)的解释器内部有一把全局锁,==同一时刻只允许一个线程执行 Python 字节码==。它的存在是为了保护CPython的内存管理(引用计数)不出现竞态条件,是一个历史设计决策。两个线程在做纯计算时(cpu密集型任务)都需要持有 GIL 才能跑。它们只能轮流持有锁、交替运行,永远无法真正并行。更糟的是,线程切换本身还有开销,实际跑下来甚至比单线程还慢。

    线程创建和多线程运行

    import threading
    from time import sleep
    
    def func(name):
        print(f"以子线程方式运行{name}")
        sleep(10)
    
    if __name__ == "__main__":
        t = threading.Thread(target=func, args=("test",))  # 创建线程对象
        t.start()  # 启动线程
        # t.join()   # 可选:等待子线程结束
        print("主线程运行结束")

    image-20260611163421000

    image-20260611163617115


    数据竞争问题,因为线程可以共享进程的全局变量,因此可以直接通过全局变量进行数据传递,以下模拟一个数据竞争问题

    import time
    from threading import Thread
    
    counter = 0
    
    
    def increment():
        global counter
        for _ in range(1000):  # 每个线程1000次
            tmp = counter
            time.sleep(0.000001)  # 关键:在读和写之间切换
            counter = tmp + 1
    
    
    threads = [Thread(target=increment) for _ in range(100)]  # 总共10万次
    for t in threads:
        t.start()
    for t in threads:
        t.join()
    
    print(f"期望: 100000, 实际: {counter}, 丢失: {100000 - counter}")
    

    使用锁限制读写,确保同一时间只有一个线程操作

    import time
    from threading import Lock, Thread
    
    lock = Lock()
    counter = 0
    
    
    def increment():
        global counter
        with lock:
            for _ in range(1000):  # 每个线程1000次
                tmp = counter
                time.sleep(0.000001)  # 关键:在读和写之间切换
                counter = tmp + 1
    
    
    threads = [Thread(target=increment) for _ in range(100)]  # 总共10万次
    for t in threads:
        t.start()
    for t in threads:
        t.join()
    
    print(f"期望: 100000, 实际: {counter}, 丢失: {100000 - counter}")

    image-20260611184804789


    线程同步

    线程同步方案与进程类似,知道有数据竞争问题是核心,与进程一样,使用锁、信号量可以解决。条件变量和事件不做要求。知道存在即可。

    线程共享方案

    ​ 1. 共享全局变量+Lock

    ​ 2. 队列

    import queue
    import threading
    
    q = queue.Queue(1)
    
    def worker():
        data = q.get()
        print(f"收到: {data}")
    
    
    threading.Thread(target=worker).start()
    q.put("hello")
    q.put("world")
    q.put("!")
    

    跟随线程

    Thread(target=increment, daemon=True)

    线程池

    from concurrent.futures import ThreadPoolExecutor
    
    def square(n):
        return n * n
    
    # 使用with不用自己手动关闭线程池
    # executor = ThreadPoolExecutor(max_workers=3)
    # executor.shutdown(wait=True)
    with ThreadPoolExecutor(max_workers=3) as executor:
        resultMap = list(executor.map(square, [1, 2, 3, 4, 5]))
        print(resultMap)
        resultSinge = []
        for task in [1, 2, 3, 4, 5]:
            r = executor.submit(square, task)
            resultSinge.append(r.result())
        print(resultSinge)
    import time
    from concurrent.futures import ThreadPoolExecutor
    
    import requests
    
    urls = [
        "https://www.baidu.com",
        "https://www.zhihu.com",
        "https://www.bilibili.com",
        "https://www.baidu.com",
        "https://www.zhihu.com",
        "https://www.bilibili.com",
        "https://www.baidu.com",
        "https://www.zhihu.com",
        "https://www.bilibili.com",
    ]
    
    
    def fetch(url):
        print(f"开始下载: {url}")
        resp = requests.get(url, timeout=5, verify=False)
        print(f"完成下载: {url}, 大小={len(resp.content)}")
        return len(resp.content)
    
    
    # ========== 多线程版本(使用 submit + shutdown)==========
    print("=== 多线程版本 ===")
    start = time.time()
    
    # 创建线程池
    executor = ThreadPoolExecutor(max_workers=5)
    
    # 提交所有任务,保存 future 对象
    futures = []
    for url in urls:
        future = executor.submit(fetch, url)
        futures.append(future)
    
    # 关闭线程池(不再接受新任务)
    executor.shutdown(wait=True)  # wait=True 等待所有任务完成
    
    # 获取结果
    results = [future.result() for future in futures]
    
    thread_time = time.time() - start
    print(f"多线程耗时: {thread_time:.2f}秒n")
    
    # ========== 单线程版本 ==========
    print("=== 单线程版本 ===")
    start = time.time()
    results_single = [fetch(url) for url in urls]
    single_time = time.time() - start
    print(f"单线程耗时: {single_time:.2f}秒n")
    
    # ========== 对比 ==========
    print("=== 对比 ===")
    print(f"多线程: {thread_time:.2f}秒")
    print(f"单线程: {single_time:.2f}秒")
    print(f"提升倍数: {single_time / thread_time:.1f}x")
    

    ==总结==:

    image-20260611201356753

    进程和线程的设计还是有区别的

    image-20260611201931885

    image-20260611202413998


    python协程

    单线程内做到并发执行。一个协程写法如同函数,只是执行的方式与普通函数不同

    背景

    假设我们要开发一个高并发的Web服务器,需要同时处理 10,000 个并发请求(C10K问题)。如果我们用“一台服务器 + 传统多线程(1个请求=1个线程)”的模型,会发生什么?

    传统多线程的“三座大山”

    内存撑爆: 在 64 位 Linux 系统中,一个线程的默认栈大小通常是 8MB(即便调小,最低一般也需要几十到几百KB)。10000个线程需要80G左右内存,硬件成本极高。

    上下文切换(Context Switch)内耗: 线程是由操作系统内核调度的。当 10,000 个线程频繁切换时,操作系统光是保存和恢复 CPU 寄存器等,就会把 CPU 的算力消耗殆尽。CPU 都在忙着“办手续”,没空“干正事”。

    线程竞争: 为了防止数据死锁或错乱,必须加锁(Lock),这会导致线程挂起,进一步加剧切换开销。

    能不能有一种技术,既能享受异步I/O的高效,又能像写同步代码一样简单,而且轻量到一台机器能跑几十万个? 这就是协程(Coroutine)。

    对比普通函数(1分钟)

    普通函数:调用 → 执行 → return(结束)

    协程函数:调用 → 执行 → await(暂停)→ 恢复 → 继续

    核心语法

    async def:定义协程函数

    await:启动并运行协程函数,且等待直到拿到协程函数的返回值

    asyncio.run():启动事件循环

    import asyncio
    
    
    async def asyncTask():
        print("hello world")
        return 1
    
    
    async def main():
        a = asyncTask()      #  异步任务此时并没有执行,只是拿到了一个协程对象
        #a = create_task(asyncTask())
        result = await a     #  异步任务在此启动运行,并直到运行结束,把协程函数返回值赋值给result
        print(result)
    
    asyncio.run(main())

    ==重点知识==

    ​ 1. await必须在async函数中

    ​ 2. await可以启动并拿到一个async函数的执行结果

    并发的关键操作

    一定要让任务立即提交给队列,才能做到并发。

    而常用的gather和create_task都可以做到

    使用gather同时运行多个任务

    多个任务同时执行,同时拿到所有任务的结果。如果任何一个任务失败,抛出异常;如果使用了asyncio.gather(task_a, task_b, return_exceptions=True)此参数,不会整体抛出异常,仅失败的抛出。

    import asyncio
    import time
    
    start = time.time()
    
    
    async def task(name, delay):
        await asyncio.sleep(delay)
        print(f"{name} 完成")
        return name
    
    
    # async def taskErr():
    #     raise RuntimeError("任务出错")
    
    
    async def main():
        # 创建3个任务,分别延迟2秒、1秒、3秒
        # await task("A", 2)
        # await task("B", 1)
        # await task("c", 3)
        results = await asyncio.gather(task("A", 2), task("B", 1), task("C", 3))
        print(results)
    
    
    asyncio.run(main())
    end = time.time()
    print(f"耗时: {end - start:.2f}秒")

    image-20260612065109160

    怎么识别异步任务?

    1. async函数的能力范围

    async函数只是声明了一个协程函数,并不是当中的操作都自动变成异步了。如果你依然使用了内置的同步api,那事件循环在执行async函数时,依然是阻塞状态。如下示例

    import asyncio
    import time
    from asyncio.tasks import create_task
    
    
    async def asyncTask():
        time.sleep(1)  # 你觉得会被放入队列的代码,所有的操作都需提供异步支持
    
    
    async def main():
        start = time.time()
        a = create_task(asyncTask())
        b = create_task(asyncTask())
        c = create_task(asyncTask())
        await a
        await b
        await c
        end = time.time()
        print(f"Total took {end - start} seconds")
    
    asyncio.run(main())
    

    2. 如何识别异步函数呢

    一般一个库函数支持异步,会在文档中声明支持async/await

    常用的功能异步库

    网络请求: httpx

    import asyncio
    import time
    
    import httpx
    
    
    async def task():
        client = httpx.AsyncClient()
        start = time.time()
        response = await client.get("https://www.baidu.com")
        end = time.time()
        print(f"一次请求所花时间{end - start}秒")
        print(response.status_code)
        await client.aclose()
    
    
    async def main():
        tasks = []
        for _ in range(15):
            tasks.append(asyncio.create_task(task()))
        for t in tasks:
            await t
    
    
    mainStart = time.time()
    asyncio.run(main())
    mainEnd = time.time()
    print(f"总耗时{mainEnd - mainStart}秒")

    文件读写: aiofiles

    那如果实在要在写成函数中使用同步api怎么办呢?使用run_in_executor包裹一层

    import asyncio
    import time
    from asyncio.tasks import create_task
    
    from concurrent.futures import ThreadPoolExecutor
    executor = ThreadPoolExecutor()
    
    async def asyncTask():
        loop = asyncio.get_event_loop()
        # 线程池封装,其实削足适履了,就用不了协程特性了
        await loop.run_in_executor(executor, time.sleep, 1)
    
    
    async def main():
        start = time.time()
        a = create_task(asyncTask())
        b = create_task(asyncTask())
        c = create_task(asyncTask())
        await a
        await b
        await c
        end = time.time()
        print(f"Total took {end - start} seconds")
    
    
    asyncio.run(main())
    

    image-20260612072640235

    image-20260612073116511

    ==总结==:

    image-20260612063017565

    image-20260612063141099

    image-20260612063204192

    image-20260612063407707

    ==本质总结==:

    image-20260612074002433

    image-20260612074138353

    协程同步

    见课件

    课程结尾

    ​ 1. 希望大家自己学习git,配合国内的gitee.com学会代码管理和分支管理

    ==全部总结==:

    image-20260612075119542

  • Python 扩展知识

    Python 解释器有多种实现,它们各自有不同的设计目标和适用场景。其中最主流的是 CPython 和 PyPy,此外还有几个重要的其他实现。

    下面我将为你介绍它们的特点,并重点对比 CPython 与 PyPy。

    核心对比:CPython vs. PyPy

    特性 CPython PyPy
    实现语言 C 语言 Python 的一个子集(称为 RPython)
    运行机制 解释执行字节码 即时编译,将频繁执行的代码编译为机器码
    速度 解释执行,速度较慢 通常快 2-5 倍,特别适合长时间运行的程序
    内存占用 相对较高 内存占用通常更小(得益于分代回收和压缩算法)
    兼容性 官方标准,兼容性最好(几乎所有第三方库都支持) 高度兼容,但部分 C 扩展库(如 numpy, pandas)支持不佳
    启动时间 快 较慢(因为 JIT 预热需要时间)
    适用场景 通用开发、脚本、短生命周期的任务 长时间运行的应用(如 Web 后端)、计算密集型任务

    补充说明:

    PyPy 为什么不能完全兼容 C 扩展?

    PyPy 和 CPython 的对象模型在内存结构上存在根本差异。为了让 PyPy 也能运行 C 扩展,需要一个叫做 cpyext 的模拟层,但这个模拟层的效率很低,通常会抵消掉JIT 带来的性能优势,让程序变得比 CPython 还要慢。因此,对于重度依赖 C 扩展的项目,PyPy 目前还不是一个合适的选择。

    一、CPython 详解

    1. 实现语言与架构

    CPython 完全用 C 语言 编写。它的核心是一个字节码解释器,也叫做虚拟机。

    工作流程:

    1. 源代码解析:将 .py 文件解析成抽象语法树。
    2. 编译为字节码:将 AST 编译成平台无关的字节码(例如 LOAD_FAST、BINARY_ADD、RETURN_VALUE)。
    3. 解释执行:主循环是一个巨大的 switch 语句,根据当前字节码指令跳转到对应的 C 代码段执行。

    例如,a + b 会被编译成:

    text

    LOAD_FAST   a
    LOAD_FAST   b
    BINARY_ADD
    RETURN_VALUE

    解释器逐条执行这些指令。

    2. 为什么 CPython 相对较慢?

    • 动态类型:每次 BINARY_ADD 都必须检查两个对象的类型(是整数?浮点数?列表?自定义对象?),然后分派到不同的加法逻辑。C 语言 int a+b 只是一条 CPU 指令。
    • 解释开销:每个字节码指令都要经历取指、解码、分派、执行、跳转,比直接执行机器码多几个数量级的开销。
    • 全局解释器锁:限制了多线程真正并行执行 Python 字节码(虽然 I/O 操作会释放锁)。

    3. 优点

    • 稳定性与兼容性:官方实现,所有 PEP 必须先在此实现。几乎 100% 的第三方库(包括 C 扩展)都支持 CPython。
    • 调试与嵌入:C API 稳定,可以轻松用 C/C++ 写扩展模块,或者把 Python 嵌入到大型 C 项目中。
    • 启动速度快:没有 JIT 预热过程,适合一次性脚本。

    二、PyPy 详解

    1. 实现语言:RPython

    PyPy 最独特的一点:它本身是用 Python 的一个子集——RPython 编写的。RPython 是一个受限制的 Python(没有动态类型、反射等功能,但足够表达解释器的逻辑)。

    然后,PyPy 项目使用一个元跟踪 JIT 编译器生成工具链,将 RPython 代码编译成 C 语言,再编译成可执行文件。所以最终的 PyPy 解释器是一个经过 JIT 支持的二进制程序。

    2. 核心:即时编译

    PyPy 内部仍然先把 Python 源代码编译成字节码,但不会直接解释。它会:

    • 开始用解释器运行代码(慢)。
    • 同时跟踪哪些代码路径被频繁执行(比如循环、热点函数)。
    • 当某个循环执行次数超过阈值(如 1000 次),PyPy 的 JIT 会将那段字节码编译成机器码(x86/ARM 等)。
    • 下次执行直接运行机器码,并且会做优化(比如类型特化、内联、消除冗余操作)。

    举例: for i in range(1000000): total += i 第一次迭代时,PyPy 会记录变量 i 和 total 都是整数类型。JIT 会生成专门处理整数的加法循环机器码,没有动态类型检查,速度接近 C。

    3. 内存占用为什么更小?

    CPython 采用引用计数作为主要垃圾回收机制,每个对象都有额外字段维护计数,并且不会自动移动对象,导致内存碎片。 PyPy 使用分代式垃圾回收(标记-清除 + 复制收集),会不定期压缩内存,将活对象移动到一起,释放碎片空间。因此长期运行的 PyPy 进程内存占用往往比 CPython 低 20%~50%。

    4. 兼容性问题的根源

    PyPy 的目标是替代 CPython,但最大障碍是 C 扩展模块(如 numpy、pandas 内部的 C 代码)。 原因:

    • CPython 暴露的 C API 假设对象的内存布局是固定的(比如 PyObject 结构体)。
    • PyPy 的对象布局完全不同(为了实现更快的 GC 和 JIT),所以需要 模拟层 cpyext。
    • cpyext 会在每次调用 C 扩展函数时,把 PyPy 对象“转换”成假的 CPython 对象,开销极大,甚至使性能比 CPython 还差。
    • 很多 C 扩展直接操作 CPython 的内部字段,这在 PyPy 上会崩溃。

    所以结论:如果你的项目依赖 numpy/scipy/pandas/tensorflow 等,就不要用 PyPy。

    5. 启动慢与预热

    PyPy 启动时会加载 JIT 编译器和自己的运行时,比 CPython 启动慢 1-2 秒。而且 JIT 需要预热——最初几百次迭代仍然是解释执行,之后才会编译优化。因此非常短的程序(执行时间 < 0.1 秒)用 PyPy 反而更慢。


    HTTP协议基础(请求/响应模型、状态码、请求方法)

    HTTP(HyperText Transfer Protocol)是 Web 的基石,一个无状态、基于请求-响应模型的应用层协议。下面我会详细拆解它的核心概念。


    一、请求-响应模型

    HTTP 通信由客户端(如浏览器、App)发起请求,服务器处理并返回响应。每次交互都是独立的,服务器默认不保留上一次请求的状态(无状态)。

    1. 请求结构

    一个 HTTP 请求由四部分组成:

    text

    <方法> <路径> <版本>
    <头部1>: <值1>
    <头部2>: <值2>
    ...
    <空行>
    [请求体]

    示例:

    http

    POST /api/user HTTP/1.1
    Host: example.com
    Content-Type: application/json
    Content-Length: 27
    
    {"name": "Alice", "age": 25}
    • 请求行:方法 + 请求目标 + 协议版本。
    • 头部:键值对,描述元数据(如 Host、User-Agent、Cookie)。
    • 空行:分隔头部与体。
    • 请求体:可选,常用于 POST/PUT 等方法携带数据。

    2. 响应结构

    text

    <版本> <状态码> <原因短语>
    <头部1>: <值1>
    ...
    <空行>
    [响应体]

    示例:

    http

    HTTP/1.1 200 OK
    Content-Type: application/json
    Content-Length: 52
    
    {"id": 100, "name": "Alice", "age": 25}
    • 状态行:协议版本 + 状态码 + 原因短语(如 200 OK)。
    • 头部:服务器信息、内容类型、缓存策略等。
    • 空行。
    • 响应体:服务器返回的资源(HTML、JSON、图片等)。

    3. HTTP 的特点

    • 无状态:每个请求独立,可通过 Cookie、Session 等机制模拟状态。
    • 文本协议(HTTP/1.x):可读性好,但效率较低;HTTP/2 和 HTTP/3 已改为二进制帧。
    • 默认端口:HTTP 为 80,HTTPS 为 443。

    二、HTTP 状态码(Status Code)

    状态码表示服务器对请求的处理结果,共五类,首位数字区分含义。

    1xx – 信息性响应

    • 100 Continue:客户端应继续发送请求。
    • 101 Switching Protocols:服务器同意切换协议(如升级到 WebSocket)。

    2xx – 成功

    • 200 OK:请求成功,响应体包含资源(GET)或操作结果(POST)。
    • 201 Created:资源创建成功(常用于 POST 响应),Location 头指示新资源 URL。
    • 204 No Content:请求成功,但无响应体(常用于 DELETE 或 PUT 更新)。
    • 206 Partial Content:范围请求成功,用于断点续传、分片下载。

    3xx – 重定向

    • 301 Moved Permanently:永久重定向,客户端应更新书签。
    • 302 Found(临时重定向):请求的资源临时移至新 URL,客户端应继续使用原 URL。
    • 304 Not Modified:资源未修改,客户端可使用本地缓存(协商缓存)。
    • 307 Temporary Redirect:类似 302,但禁止改变请求方法(如 POST 重定向后仍是 POST)。
    • 308 Permanent Redirect:类似 301,且禁止改变请求方法。

    4xx – 客户端错误

    • 400 Bad Request:语法错误或请求参数无效。
    • 401 Unauthorized:缺少认证信息或认证失败(通常需要登录)。
    • 403 Forbidden:服务器理解请求但拒绝执行(权限不足)。
    • 404 Not Found:资源不存在。
    • 405 Method Not Allowed:请求方法不被允许(如对静态文件 PUT)。
    • 408 Request Timeout:客户端未在服务器预备等待时间内发送完整请求。
    • 413 Payload Too Large:请求体过大。
    • 429 Too Many Requests:客户端发送请求过快(限流)。

    5xx – 服务器错误

    • 500 Internal Server Error:服务器内部错误(代码异常、配置错误等)。
    • 502 Bad Gateway:网关或代理收到上游无效响应。
    • 503 Service Unavailable:服务器过载或维护中。
    • 504 Gateway Timeout:网关等待上游响应超时。

    三、HTTP 请求方法(HTTP Verbs)

    方法表明对资源期望执行的操作。RESTful API 中方法配合资源 URL 表达语义。

    方法 作用 幂等性 安全性 是否有请求体 典型场景
    GET 获取资源 是 是 否 浏览网页、查询数据
    POST 创建资源或提交数据 否 否 是 表单提交、上传文件、新建订单
    PUT 完整替换资源(全量更新) 是 否 是 更新用户信息(全量)
    PATCH 部分更新资源 否 否 是 修改用户的部分字段
    DELETE 删除资源 是 否 通常无 删除文章、用户
    HEAD 仅获取响应头(不返回体) 是 是 否 检查资源是否存在、获取元信息
    OPTIONS 查询服务器支持的请求方法 是 是 否 CORS 预检请求
    TRACE 回显服务器收到的请求(调试) 是 是 否 诊断(通常禁用)
    CONNECT 建立隧道(用于代理) 否 否 是 HTTPS 代理、WebSocket 隧道

    重要概念解释

    • 幂等性:多次执行相同请求,对服务器资源的最终效果与一次执行相同。 例:GET /user/1 无论请求几次,都返回相同资源(若资源未变)。PUT /user/1 多次发送相同数据,结果仍是那份数据。POST /orders 多次提交可能创建多个订单(不幂等)。
    • 安全性:方法不会改变服务器资源(只读)。 安全方法:GET, HEAD, OPTIONS, TRACE。

    RESTful 实践建议

    • 使用名词表示资源:/users 而不是 /getUsers。
    • 利用方法表达动作:GET /users(列表),POST /users(创建),PUT /users/1(替换),DELETE /users/1(删除)。
    • 对复杂查询使用查询参数:GET /users?role=admin。

    总结表

    组成部分 关键点
    请求-响应模型 客户端发起请求,服务器响应;HTTP 无状态;请求含方法+路径+头+体;响应含状态码+头+体。
    状态码 1xx 信息,2xx 成功,3xx 重定向,4xx 客户端错误,5xx 服务器错误。常见如 200, 404, 500。
    请求方法 GET(获取)、POST(创建)、PUT(全量更新)、PATCH(部分更新)、DELETE(删除)、HEAD(仅头)等。

  • Python面向对象

    以步骤和过程为核心的编程范式,其核心思想是将复杂问题分解为一系列可顺序执行的函数或过程,通过逐步调用来实现整体功能

    核心思想

    • 步骤分解:将问题拆解为多个子任务,每个子任务由独立的函数实现,例如,处理学生早上的活动可分解为“起床→穿衣→洗漱→去学校”等步骤,每个步骤对应一个函数
    • 顺序执行:程序按代码的书写顺序从上到下执行,通过条件语句(如if)和循环结构(如for)控制流程
    • 数据与操作分离:数据存储在全局或局部变量中,函数通过参数接收数据并处理,结果通过返回值或修改变量传递。

    典型特征

    • 模块化函数:功能封装为函数,例如计算两数之和的函数 add(),通过调用实现代码复用。
    • 线性流程:程序逻辑清晰,易于调试。例如读取文件数据→处理数据→输出结果的流程。
    • 高效性:适用于简单任务或对性能要求高的场景,因无需对象创建开销。


    面向对象(Object)

    一种以对象为核心的编程范式,通过模拟现实世界中事物的交互逻辑来构建程序。其核心思想是将数据与操作数据的方法封装成独立的对象,通过对象之间的协作实现复杂功能

    核心概念

    1. 类(Class):定义对象的模板,描述一类事物的共性特征(如属性)和行为(如方法)。例如,”汽车”类包含属性”颜色”和方法”加速”。
    2. 对象(Object):类的具体实例,拥有独立的状态(属性值)和行为。例如,一辆红色汽车是”汽车”类的对象
    3. 封装(Encapsulation):将数据和方法捆绑在对象内部,仅通过暴露的接口与外界交互,保护数据安全并简化使用。例如,银行账户的余额只能通过特定方法修改。
    4. 继承(Inheritance):子类可复用父类的属性和方法,并扩展新功能,实现代码复用和逻辑分层。例如,”电动车”类继承自”汽车”类,新增”充电”方法。
    5. 多态(Polymorphism):同一方法在不同对象中呈现不同行为,增强代码灵活性。例如,”动物”类的”发声”方法在”狗”和”猫”对象中分别输出”汪汪”和”喵喵”。
    6. 抽象(Abstraction):提取共性特征形成接口或抽象类,隐藏复杂实现细节,例如定义”图形”类的抽象方法”计算面积”。

    核心优势

    • 可维护性:对象间低耦合,修改某部分代码不影响整体系统。- 可扩展性:通过继承和多态灵活扩展功能,无需重写现有代码。- 复用性:封装后的类可跨项目重复使用,减少冗余代码。- 逻辑直观:以现实世界模型组织代码,更符合人类认知。

    两者对比

    面向过程—怎么做

    1. 把完成某一个需求的 所有步骤 从头到尾 逐步实现
    2. 根据开发需求,将某些功能独立的代码封装成一个又一个函数
    3. 最后完成的代码,就是顺序地调用不同的函数

    注重步骤与过程,不注重职责和分工,如果需求比较复杂,虽然有函数封装,但是还是会导致代码比较臃肿。开发起来比较复杂

    面向对象—谁来做

    相比较函数,面向对象是更大的封装,根据职责在一个对象中封装多个方法

    1. 在完成某一个需求前,首先确定职责 —— 要做的事情(方法)
    2. 根据职责确定不同的对象,在对象内部封装不同的方法(多个)
    3. 最后完成的代码,就是顺序地让不同的对象调用不同的方法

    特点

    1. 注重对象和职责,不同的对象承担不同的职责
    2. 更加适合应对复杂的需求变化,是专门应对复杂项目开发,提供的固定套路
    3. 需要在面向过程基础上,再学习一些面向对象的语法

    类的规范和实例化讲解


    ==注意==:1.class定义类

    ​ 2.实例化对象的时候,会自动调用 __init__ 来初始化,我们可以在 __init__ 中定义对象初始化的属性

    ​ 3.self 在实例化对象时自动=实例p1,所以可以用self.属性或方法

    ​ 4.__dir__查看对象内所有属性以及方法

    类与对象

    在面向对象中,类与对象是两个核心的概念

    类

    • 类是对一群具有相同特征或者行为的事物的一个统称,是抽象的,不能直接使用
      • 特征 被称为 属性
      • 行为 被称为 方法
    • 类就相当于制造飞机时的图纸,是一个模板,是负责创建对象的

    对象

    • 对象是由类创建出来的一个具体存在,可以直接使用。
    • 由哪一个类创建出来的对象,就拥有在哪一个类中定义的:属性 & 方法。
    • 对象就相当于用图纸制造的飞机。

    类的设计

    在使用面相对象开发前,应该首先分析需求,确定一下,程序中需要包含哪些类

    在程序开发中,要设计一个类,通常需要满足一下三个要素:

    1. 类名 这类事物的名字,满足大驼峰命名法
    2. 属性 这类事物具有什么样的特征
    3. 方法 这类事物具有什么样的行为

    大驼峰命名法

    CapWords

    类名的确定

    通常类名的选择,我们应该根据整个业务流程来提取,或者从大的角度来选择

    属性和方法的确定

    • 对对象的特征描述,通常可以定义成属性
    • 对象具有的行为,通常可以定义成方法

    类的定义

    类的基本定于语法如下:

    class Human:
        '''
        这里可以写上对于这个类的说明
        '''
        变量 = xxxx    # 这里是类的静态属性,也可以理解为该类共有的特性
        dic = {}
        l1 = []
        def __init__(self,xxx,xxx):        # 初始化方法
            pass
    
        def func(self):                    # 方法,动态属性
            pass

    类的三大特性:封装,继承和多态

    封装:将属性,方法封装到类内

    将数据和方法捆绑在对象内部,仅通过暴露的接口与外界交互,保护数据安全并简化使用

    ==注意==:最好不要给类动态增加属性,不然破坏封装性原则,可以通过继承更改

    私有和公有:访问控制

    ==注意==:约定self.__属性=属性为私有属性,def __方法(self,xxx,xxx)为私有方法,本质都可访问,java不同,私有不可外部访问

    访问:实例名._Student__属性,python语法规范就是这样

    类属性和实例属性

    类型 属于 定义位置 内存 访问方式
    类属性 类本身 类体内,方法外 只存一份,所有实例共享 类名.属性或实例.属性
    实例属性 某个具体实例 通常在__init__内用self.xxx定义 每个实例各存一份 实例.属性
    class Dog:
        species = "Canis familiaris"   # 类属性:所有狗共享的物种名
    
        def __init__(self, name):
            self.name = name           # 实例属性:每只狗有自己的名字
    
    dog1 = Dog("Buddy")
    dog2 = Dog("Lucy")
    
    print(Dog.species)      # Canis familiaris  通过类访问
    print(dog1.species)     # Canis familiaris  实例也能读(向上查找)
    print(dog2.species)     # Canis familiaris
    
    Dog.species = "犬科"      # 修改类属性
    print(dog1.species)     # 犬科(受影响,因为共享)
    
    dog1.name = "Max"        # 修改实例属性
    print(dog2.name)         # Lucy (互不影响)


    @staticmethod静态方法装饰器

    不需要传入self,本质就是个普通函数,只是放在类的命名空间里,调用直接用类.方法

    本质:为了定义类方法,类.方法读取

    计数器计算多少个实例对象

    class Dog:
        count = 0  # 类属性:计数器
    
        def __init__(self, name):
            Dog.count += 1    # 每次实例化,类属性加1
            self.name = name  # 实例属性class Dog:
        count = 0  # 类属性:计数器
    
        def __init__(self, name):
            Dog.count += 1    # 每次实例化,类属性加1
            self.name = name  # 实例属性
    
    a = Dog("Buddy")
    print(Dog.count)  # 1
    b = Dog("Lucy")
    print(Dog.count)  # 2         

    ==注意==:类属性类似于模块的全局变量,修改后全局共享,但是被命名空间限制在类里,所以由实例共享,创建一个改为1,创建第二个自动在修改后的1,后面加1变为2

    继承:复用父类的属性,方法,和增加新属性,方法

    子类可复用父类的属性和方法,并扩展新功能,实现代码复用和逻辑分层

    单继承(yes),多继承(pass)

    单继承:只继承自一个父类

    ![](Python面向对象.assets/方法重写和super()调用父类.jpeg)

    ==注意==:子类方法重写:默认覆盖父类方法,要在新方法中调用super( )父类属性或方法,再增加新功能,super只会找上一级父类,上一级也可能继承自别的,也有super(),所以不要搞的继承很多,很复杂

    多态:实例方法的角度

    同一方法在不同对象中呈现不同行为,增强代码灵活性

    ==注意==:不管实例化对象是什么,都继承了基类的基础属性和方法,直接定义一个函数,函数体内调用具体方法

    本质:调用函数把实例对象作为参数传进去,即实例对象().具体方法

    鸭子类型

    1. 如果像鸭子一样叫,就当成鸭子
    2. ==Python不强制继承关系,只要对象有对应方法就可以==

    鸭子类型的本质:它是一种”不通过继承,而通过方法兼容性”来实现多态,关注对象能做什么,而不是它是什么,偶然的行为兼容

    java vs python

    1. Python:本身就符合语法规则,天生的真’鸭子类型’
    2. Java:必须制要求显式的继承或接口关系,为了通过编译器类型检查,如果不建立显式接口关系,直接用多态的方法调用会报错,静态类型系统为了安全性和可维护性的设计选择,所以==设计鸭子类型来进行java和别的静态类型语言的多态开发==

    反射:以字符串形式直接到类方法调用

    在运行时,根据字符串动态的操作对象

    ==注意==:核心思路是由字符串直接到类方法执行,原本是创建实例调用,现在直接操作,hasattr和getattr是判读实例对象里有这个方法或属性,getattr是得到这个方法或属性

    Python测试框架原理

    • globals( )打印结果
    { '_name_': '_main_', '_doc_': None, '_package_': None, '_loader_': <frozen_importlib_external.SourceFileLoader object at 0x0000023358750680>,
     '_MathTwoNumber_': '_run_all_tests_': <function run_all_tests at 0x0000023358750680>}None, '__loader__': <frozen_importlib_external.SourceFileLoader object at 0x0000023358781C10>, '_spec__': None, '_annotated_namespace': None, '_file__': 'C:UsersLiDesktopprojectdeepseekaitext.py', '_cached__': None, 'MathTwoNumber': <Class '__main__.MathTwoNumber >,'run_all_tests': <function run_all_tests at 0x0000023358750680> }

    globals()以字典形式把 内置名称,当前模块的模块信息,自定义的全局变量、函数、类,导入的模块

    • dir(instance)运行结果是:实例对象的所有方法名
    (venv) PS C:UsersliDesktopprojectdeepseekai> python .text.py
    add方法通过测试
    mul方法通过测试
    ['__class__', '__delattr__', '__dict__', '__dir__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__getstate__', '__gt__', '__hash__', '__init__', '__init_subclass__', '__le__', '__lt__', '__module__', '__ne__', '__new__', '__reduce__', '__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__', '__weakref__', 'a', 'add', 'b', 'mul', 'test_add', 'test_mul']
    • globals()[test_class_names]运行结果:在globals( ) 字典里取相应的类

    MRO算法

    多继承中,子类调用一个属性或顺序时,Python按照什么顺序在继承链中搜索

    口诀:子类在前,父类在后 ; 多父类时,左父先于右父;最后运行共同父类,只运行一次

    class A: pass
    class B(A): pass
    class C(A): pass
    class D(B, C): pass
    
    object
      |
      A
     / 
    B   C
      /
      D
    
    
    MRO(D) →  [ D ,  B ,  C ,  A ,  object ]
    
    顺序方向:从左到右查找
    

    本质:你写的代码经过MRO算法会优化搜索顺序

  • Python面向函数

    函数是一段组织好的、==可重复使用==的代码,用于==执行特定的任务==。函数==接受参数==,并可以返回输出。函数可以帮助我们组织代码,提高可读性和重用性。

    Python函数编程

    函数定义

    函数定义用 def 关键字,后面跟函数名和参数列表,函数体由缩进的代码块组成。

    语法:

    def function_name(参数):
        """函数的文档字符串,来描述函数做什么的"""
        # 函数体
        # 执行任务的代码

    函数调用

    调用函数时,要使用函数名,并==传入参数==。

    函数返回值

    函数用 return 语句得到返回值,没有 return,函数默认返回 None。

    return 关键字的作用:

    • return后面的值叫“返回值”
    • 没return的情况下,会默认返回一个 None
    • 一旦遇到 return,结束整个函数
    • 返回多个值会被组织成元组返回,也可以用多个值来接收
    • 使用多个值接收(值的数量必须跟返回值数量对应)

    示例:

    # 1. 无返回值的函数(默认返回None)
    def greet():
        print("Hello!")
    
    result = greet()
    print(f"函数无返回值return: {result}")  # 输出: None
    
    # 2. 单返回值的函数
    def calculate_square(number):
        return number ** 2
    
    square = calculate_square(5)
    print(f"5的平方是: {square}")  # 输出: 25
    
    # 3. 多返回值的函数
    def get_user_info():
        name = "张三"
        age = 25
        city = "北京"
        return name, age, city
    
    # 使用多个变量接收返回值
    user_name, user_age, user_city = get_user_info()
    
    print(f"用户信息: {user_name}, {user_age}岁, 来自{user_city}")
    
    # 使用单个变量接收(返回值会被组织成元组)
    user_info = get_user_info()
    print(f"用户信息(元组): {user_info}")、
    
    #用户信息(元组) : ('张三',25,'北京')
    
    # 4. 条件返回的函数
    def check_number(num):
        if num > 0:
            return "正数"
        elif num < 0:
            return "负数"
        else:
            return "零"
    
    print(check_number(10))   # 输出: 正数
    print(check_number(-5))   # 输出: 负数
    print(check_number(0))    # 输出: 零

    形参

    函数定义时来占位置的字符,表示要传入这个参数

    • 形参是在函数定义时指定的参数,用于接收函数调用时传递的实参值。
    • 形参在函数体内作为变量存在,作用域仅限于函数内部。

    实参

    函数调用的时候实际传进去的参数,是一个具体的值,==处理函数内部==

    • 实参是在函数调用时传入的实际值,实参可以是常量、变量、表达式或==其他函数的返回值==
    • 实参的值被传递给形参

    位置参数

    位置参数调用时根据位置传递给函数。参数的数量和顺序必须与函数定义时一致。

    默认参数

    默认参数为函数的参数设置默认值。调用函数时,如果没有提供该参数 实参,则使用默认值。

    关键字参数

    按照形参的参数名进行精确传参,不考虑顺序

    示例:

    # 形参 & 实参
    def greet01(name):
        print(f"Hello, {name}!")
    
    greet01("EaglesLab") 
    greet01("英格科技")
    
    # 位置参数
    def greet02(name, age):
        print(f"Hello, {name}! Age: {age}")
    
    greet02("EaglesLab", 11)
    
    # 默认参数 & 关键字参数 & 可选参数
    def greet03(name, site="cloud.eagleslab.com", address="zj"):
        print(f"Site: {site}, Address: {address}")
    
    greet03(address="nj", site="ncloud.eagleslab.com", name="EagelsLab")

    动态参数

    动态参数在函数定义时接受很多数量的实参。这种特性使得函数可以处理很多实参,不需要在定义时明确列出所有参数。Python 提供了两种主要方式来实现动态参数:*args 和 **kwargs。

    *args 允许函数接受任意数量的位置参数,这些参数会被收集到一个 ==元组==中。

    def sum_numbers(*args):
        total = sum(args)                #  args 是一个元组
        return total
    
    result = sum_numbers(1, 2, 3, 4, 5)  # 可以传入任意数量的参数
    print(result)  # 输出: 15

    **kwargs 允许函数接受任意数量的关键字参数,这些参数会被收集到一个==字典==中,name =‘ Str ’

    def print_info(**kwargs):
        for key, value in kwargs.items():             #  kwargs 是一个字典
            print(f"{key}: {value}")
    
    print_info(name="EaglesLab", age=10, city="China")
    
    # Output:
    name: EaglesLab
    age: 30
    city: China

    可以在同一个函数中同时使用 *args 和 **kwargs,但 *args 必须在 **kwargs 之前。

    def display_info(*args, **kwargs): 
        print("位置参数:", args)             # args   是一个元组
        print("关键字参数:", kwargs)         # kwargs  是一个字典
    
    display_info(1, 2, 3, name="Alice", age=30)
    
    # Output:
    位置参数: (1, 2, 3)
    关键字参数: {'name': 'Alice', 'age' : 18}

    ==注意==:args是 作为 元组的形参,可调用函数传递参数进去

    ​ kwargs是 作为字典的形参,接受关键字实参

    命名空间和作用域

    命名空间(Namespace)和作用域(Scope),它们帮助我们理解变量的可见性和生命周期。下面将详细解释这两个概念,并展示它们之间的关系。

    命名空间

    命名空间是一个容器,用于存储变量名(或标识符)与对象(值)之间的映射关系。命名空间确保了变量名的唯一性,不同的命名空间可以包含同名的变量而不会产生冲突。

    类型

    • 内置命名空间:包含 Python 内置的函数和对象,如 len()、print() 等

    • 全局命名空间:模块级别的命名空间,包含模块中定义的变量和函数

    • 局部命名空间:函数内部的命名空间,包含函数内部定义的变量

    作用域链

    作用域链是指在查找变量时,Python 按照一定的顺序查找变量的规则。它遵循 LEGB 规则:

    1. Local (局部作用域):当前函数内定义的变量。
    2. Enclosing (包围作用域):外层函数中的局部变量。
    3. Global (全局作用域):模块级别定义的变量。
    4. Built-in (内置作用域):Python 内置的名字,如 len()、print() 等

    ==注意==:print( )等在所有情况都可用,为内置的,就区分全局和局部作用域就行


    global 和 nonlocal 关键字

    global 关键字用于在==函数内部声明==一个变量是==全局变量==,从而允许你在函数内部对其进行修改。

    x = 10                  # 全局变量
    
    def modify_global():
        global x            # 声明 x 为全局变量
        x = 20              # 修改全局变量
    
    modify_global()         # 改了   x=20
    print(x)                # 输出: 20

    如果不使用 global,在函数内部直接赋值会创建一个新的局部变量,而不会影响全局变量。

    x=20
    def try_modify():
        x = 30  # 创建一个局部变量 x,未声明为 global
        print(x)  # 输出: 30
    
    try_modify()  # 输出:30
    print(x)  # 输出: 20,仍然是全局变量的值

    对可变数据类型(list,dict,set)可以直接引用不用通过 global

    li = [1,2,3]
    dic = {'name':'aaron'}
    
    def change():
        li.append(4)
        dic['age'] = 18
        print(dic)
        print(li)
    
    change()      # 输出:print(dic)和print(li)
    print(dic)    # 同样输出2个print
    print(li)

    nonlocal 关键字用于在嵌套函数中声明一个变量是外层函数的局部变量。它允许内层函数修改外层函数的变量。

    在局部作用域中,对父级作用域变量修改,从那层及以下此变量全部发生改变。

    def outer_function():
        x = 10  # 外层函数的局部变量
    
        def inner_function():
            nonlocal x  # 声明 x 为外层函数的局部变量
            x = 20      # 修改外层函数的变量
    
        inner_function()
        print(x)  # 输出: 20
    
    outer_function()   #输出: 20

    ==注意==:nonlocal 仅在嵌套函数中有效,不能用于声明全局变量

    函数的嵌套

    函数的嵌套,内层函数可以访问外层函数的变量,但是外层函数不可访问内层函数的变量

    嵌套调用

    嵌套调用指的是在一个函数内部调用另一个函数,使用另一个函数的功能

    闭包函数

    ==内部函数==包含对==外部作用域==而非全局作用域变量的引用,该内部函数称为闭包函数

    1. 嵌套函数:闭包函数通常是在另一个函数内部定义的。
    2. 持有外部变量:闭包可以访问其外部函数的局部变量,即使外部函数已经执行完毕。
    3. 状态保持:闭包允许你在多个函数调用之间保持状态。
    def func():
        name = '张三'
        def inner():
            print(name)
        return inner
    #  首先函数体最终作用是在终端里print(),同时可以用变量接受返回值,用f()来调用函数实现输出,返回值和输出并不相干
    f = func()   
    f()

    ==注意==:通过调用外部函数得到==内部函数名返回值==,再次f ( )调用内部函数

    判断闭包函数

    判断闭包函数的方法 __closure__

    def func():
        name = 'EaglesLab'
        def inner():
            print(name)
        return inner
    
    f = func()
    print(f.__closure__)    #  打印出的内容非空,说明该函数是闭包函数
    
    name = 'EaglesLab'
    def func():
    
        def inner():
            print(name)
        return inner
    
    f = func()
    
    print(f.__closure__)    # None,说明该函数没有应用外部作用域的变量,不满足闭包函数的条件

    案例:获取网页内容

    我们需要多次访问一个静态网站,使用==闭包函数==将第一次访问到的网页内容==封装到外部作用域的变量==中,以后我们只需要调用该变量就可

    用==闭包的方式==改写如下:

    from urllib.request import urlopen
    
    def func():
        content = urlopen('https://myip.ipip.net').read().decode('utf-8')
        def inner():
            print(content)
        return inner
    
    f = func()
    for i in range(5):
        f()
    
    print(f.__code__.co_freevars)

    ==注意==:第一次访问的内容封装到content变量里,里面定义内部函数:打印内容,之后需要用到内容就调用内部函数

    Python装饰器

    装饰器,可以在不修改函数代码的情况下,动态地修改函数。装饰器本质上是一个函数,它接受一个函数作为参数并返回一个新的函数。

    已知有一个函数 func1(),作用是输出一句话。现在我们想要给他增加额外的功能。但是为了保障已有功能的稳定,不能更改原函数。

    
    def func1():
        print("in func1")
    
    # 新的需求,能够打印如下内容...
    # hello world
    # in func1                     中间这个是之前定义的函数,可直接在另一个函数体内调用
    # hello python
    
    # 实现
    def func2(func):
        def inner():
            print("hello world")
            func()        #  就是前一个函数调用,这个是基础内容不能更改,其他代码是新增加的功能
            print("hello python")
        return inner
    
    return_func_name = func2(func1)  # inner
    return_func_name()   # 相当于直接调用闭包函数的内部函数

    理解装饰器

    ==注意==:最后的func1=inner,属于直接调用内部函数,@传进去的函数作为内部函数代码块运行

    装饰带多个参数的函数

    利用了函数里面的动态参数进行传参

    def my_decorator(func):
        def wrapper(*args, **kwargs):
            # 打印传入的参数
            print(f"调用 {func.__name__} 函数,参数: {args}, 关键字参数: {kwargs}")
            # 调用原始函数并获取结果
            result = func(*args, **kwargs)
            # 打印返回结果
            print(f"{func.__name__} 函数返回: {result}")
    
            return result
        return wrapper
    
    @my_decorator
    def add(x, y):
        """返回两个数的和"""
        return x + y
    
    # 测试
    result = add(5, 3)
    print(f"最终结果: {result}")
    #输出:调用add函数,参数(5,3),关键字参数:{} 
    add函数返回:8
    最终结果8

    wraps装饰器

    wraps装饰器用于保留被装饰函数的元数据(如函数名称,属性…..),专为装饰器设置的辅助装饰器,让被装饰函数保持原来那个函数

    ==注意==:wraps(fn)的作用是把原始函数func1()复制到装饰器的内部函数inner()上,让内部函数被执行看起来像原来的函数

    多个装饰器装饰一个函数

    装饰器固定结构

    from functools import wraps
    
    def decorator_with_args(param):
        def actual_decorator(func):
            @wraps(func)
            def wrapper(*args, **kwargs):
                print(f"装饰器参数: {param}")
                return func(*args, **kwargs)
            return wrapper
        return actual_decorator
    
    @decorator_with_args("配置参数")
    def my_function():       ##     最后直接调用  my_function()函数得到封装的函数
        pass

    迭代器与生成器

    可迭代对象

    使用 for i in xxx 对字符串、列表、元组、字典、集合进行循环取值的过程称为遍历,也叫做迭代

    i = [1, 2, 3, 'a', 'b', 'c']
    for i in li:
        print(i)
    
    str = "hello,world"
    for j in str:
        print(j)
    
    dic = {'name': 'nls', 'age': 18, 'job': 'teacher'}
    for k,v in dic.items():
        print(k,v)

    定义

    可迭代对象是能够通过迭代逐一返回其元素的对象,它必须满足以下两个条件:

    • 实现 __iter__() 方法,返回一个迭代器对象
    • 实现 __getitem__() 方法,支持从索引0开始的顺序访问

    迭代器

    迭代器是一个对象,记录遍历的位置。

    可迭代对象可以通过 __iter__ 方法返回一个迭代器。我们在迭代一个可迭代对象的时候,实际上就是先获取该对象提供的一个迭代器,然后通过这个迭代器来依次获取对象中的每一个数据

    上面讲到迭代是访问集合元素的一种方式,而迭代器是一个可以记住遍历的位置的对象。迭代器对象从集合的第一个元素开始访问,直到所有的元素被访问完结束,迭代器只能往前不会后退

    ==注意==:就是一个对象,用来记录遍历的位置

    迭代器协议

    迭代器遵循迭代协议,内部主要定义了 __iter__() 和 __next__() 两个方法

    • __iter__() 方法用于初始化一个迭代器,返回迭代器本身
    • __next__() 方法用于迭代下一个数据,当没有元素可返回时,抛出 StopIteration 异常。

    初始化迭代器

    list1 = [1,2,3,'a','b','c']
    
    list_iter = list1.__iter__()    # list 是可迭代对象,这里我们调用 iter 方法初始化一个迭代器l ist_iter
    item = list_iter.__next__()     # 这里通过 next 方法来获取下一个数据
    print(item)
    item = list_iter.__next__()
    print(item)
    item = list_iter.__next__()
    print(item)
    item = list_iter.__next__()
    print(item)
    item = list_iter.__next__()
    print(item)
    item = list_iter.__next__()
    print(item)

    如果超出迭代范围,会触发 StopIteration异常,我们可以加上异常处理,取完值后自动停止

    list1 = [1,2,3,'a','b','c']
    
    list_iter = list1.__iter__()
    while True:
        try:
            print(next(list_iter))        # 这里是 next 方法的另一种写法
        except StopIteration:
            print('迭代完成')
            break

    for 循环的本质

    我们常用的 for 循环其实本质上就是迭代器协议的一种具体实现,为我们提供了一个遍历的迭代元素的方法

    工作原理:

    当你使用 for 循环遍历一个可迭代对象时,实际上发生了以下几个步骤:

    1. 调用

      __iter__()
      • for 循环首先调用对象的 __iter__() 方法,获取一个迭代器对象。
    2. 调用

      __next__()
      • 然后,for 循环在迭代器上反复调用 __next__() 方法,以获取下一个元素。
    3. 处理

      StopIteration
      • 一旦 __next__() 抛出 StopIteration 异常,for 循环停止迭代。

    生成器

    就是一种迭代器

    生成器函数:含有yield关键字

    生成器是一个函数,但与普通函数不同,它使用 yield 关键字来返回值。每次调用生成器函数时,它会从上次 yield 的地方继续执行,直到遇到下一个 yield 或函数结束

    ==调用生成器函数==不会得到返回的具体的值,而是得到一个迭代器,每一次获取这个迭代器值,就能推动函数的执行,获取新的返回值。直到函数执行结束。

    def numbers(n):
        """生成从 1 到 n 的自然数"""
        for i in range(1,n+1):
            yield i                 
    
    for i in numbers(10):
        print(i)

    ==注意==:生成器函数本质就是把函数切割为片段,分段手动执行, ==return==关键字不生效

    惰性求值

    生成器在需要时生成值,而不是一次性计算和返回所有值。这可以节省内存,特别是处理大型数据集时

    <img src=”https://li-zheng-blog-2026.oss-cn-shanghai.aliyuncs.com/blog/%E6%83%B0%E6%80%A7%E6%B1%82%E5%80%BC.png” />

    send

    • send 获取下一个值的效果和next基本一致
    • 在获取下一个值的时候,给上一个 yield 的位置传递一个数据
    • 使用 send 的注意事项
      • 第一次使用生成器的时候 是用 nex t获取下一个值
      • 最后一个 yield 不能接受外部的值
    def generator():
        print(123)
        content = yield 1
        print('欢迎来到',content)
        print(456)
        yield 2
    
    g = generator()
    ret = g.__next__()
    print('***',ret)     # 输出123,1
    ret = g.send('英格科技')
    print('***',ret)     # 输出 欢迎来到,英格科技

    ==注意==:send与next关系:1.next(g)等价于g.send(None),都驱动生成器运行到下一个yield,但send(value)能把里的value传给上一个yield关键字前面,然后运行第二次:从content=英格科技,print,print,到yield 2

    本质就是:生成器函数是静态的,要添加值就用send方法把值分段添加到函数里分段执行

    Python推导式

    列表推导式

    列表推导式主要是用于按照我们指定的内容填充,生成一个新的列表,基本语法如下:

    new_list = [ (expression)   for item in iterable      (if condition) ]
    # expression    为想得到的列表内容
    # if condition  为 元素满足条件满足才能返回值

    示例

    # 生成0~10的一个列表
    l = [i for i in range(11)]
    print(l)                # 输出: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
    
    # 生成平方数的列表
    squares = [x ** 2 for x in range(10)]
    print(squares)          # 输出: [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]
    
    # 生成偶数的列表
    even_numbers = [x for x in range(20) if x % 2 == 0]
    print(even_numbers)      # 输出: [0, 2, 4, 6, 8, 10, 12, 14, 16, 18]

    案例

    1. 找到嵌套列表中名字含有两个及以上‘a’的所有名字
    fruits = [['peach','Lemon','Pear','avocado','cantaloupe','Banana','Grape'],
              ['raisins','plum','apricot','nectarine','orange','papaya']]
    
    print( [ (name) for lst in fruits  for name in lst  (if name.count('a') >= 2) ] )
    /
    # Output:
    ['avocado', 'cantaloupe', 'Banana', 'papaya']

    集合推导式

    集合推导式用于生成一个新的集合,它的语法与列表推导式类似,但使用大括号 { }

    new_set = { (expression)  for item in iterable  (if condition) }

    示例

    # 生成平方数的集合
    squares_set = {x ** 2 for x in range(10)}
    print(squares_set)  # 输出: {0, 1, 4, 9, 16, 25, 36, 49, 64, 81}
    
    # 生成唯一的字符集合
    unique_chars = {char for char in "hello world"}
    print(unique_chars)  # 输出: {'h', 'e', 'l', 'o', ' ', 'r', 'w', 'd'}

    案例

    计算列表中每个值的平方,自带==去重==功能

    l = [1,2,3,4,1,-1,-2,3]
    
    squared = {x**2  for x in l }
    print(squared)
    
    # Output:
    {16, 1, 4, 9}

    字典推导式

    我们可以使用字典推导式生成一个新的字典

    new_dict = { (key_expression:value_expression)  for item in iterable   (if condition) }

    示例

    # 生成平方数的字典
    squares_dict = { (x:x**2) for x in range(10) }
    print(squares_dict)  # 输出: {0: 0, 1: 1, 2: 4, 3: 9, 4: 16, 5: 25, 6: 36, 7: 49, 8: 64, 9: 81}

    案例

    1. 将一个字典的 key 和 value 对调
    dic1 = {'a':1,'b':2}
    
    dic2 = { dic1[k]: k  for k in dic1 }
    print(dic2)
    1. 合并大小写对应的value值,将k统一成小写
    dic1 = {'a':1,'b':2,'y':1, 'A':4,'Y':9}
    
    dic2 = {k.lower():dic1.get(k.lower(),0) + dic1.get(k.upper(),0) for k in dic1.keys()}
    print(dic2)

    内置函数和匿名函数

    内存相关

    hash()

    获取一个对象(可哈希对象:int,str,bool,tuple)的哈希值

    print(hash(12322))
    print(hash('123'))
    print(hash('arg'))
    print(hash('aaron'))
    print(hash(True))
    print(hash(False))
    print(hash((1,2,3)))

    id()

    用于获取对象的内存地址

    print(id('abc'))
    print(id('123'))

    ==注意==:hash( ) 只生成哈希值,然后哈希表按照编号快速定位,就像一个新华字典,根据哈希值找对应的位置

    ​ id( )返回对象的内存地址,不会变,判断两个变量a和b,是否相同,a==b,就是再比较两个的内存地址是否相同

    数据结构相关操作

    filter()

    过滤序列中不符合条件的元素,返回由符合元素组成的新的迭代器

    ![](https://li-zheng-blog-2026.oss-cn-shanghai.aliyuncs.com/blog/filter()%E8%BF%87%E6%BB%A4%E5%99%A8.png)

    map()

    将指定函数应用于可迭代对象中的每个元素,并返回一个迭代器。这个函数非常有用,可以简化对数据的转换和处理

    def square(x):
        return x**2
    
    list1 = [1,2,3,4,5,6,7,8]
    
    ret = map(square,list1)         
    print(ret)
    
    for i in ret:
        print(i)

    匿名函数

    匿名函数是指没有名称的函数,通常使用 lambda 关键字定义。匿名函数可以用于需要函数作为参数的场合,比如在 map()、filter() 和 sorted() 等函数中

    语法

    lambda 参数: 表达式
    • 参数可以有多个,用逗号隔开
    • 匿名函数不管逻辑多复杂,只能写一行,且逻辑执行结束后的内容就是返回值
    • 返回值和正常的函数一样可以是任意数据类型

    示例:

    #   自定义函数的方法
    def func1(n):
        return n ** n
    
    print(func1(10))
    
    # 换成匿名函数
    func2 = lambda n: n ** n
    print(func2(10))

    案例

    1. 计算两个数的和
    add = lambda x, y: x + y
    print(add(2, 3))  # 输出: 5
    1. 配合 map() 使用
    list1 = [1,2,3,4,5,6,7,8]
    
    ret = map(lambda x: x ** 2,list1)
    print(ret)
    
    for i in ret:
        print(i)
    1. 配合 filter() 使用
    ret = filter(lambda x: x % 2 == 0,[1,2,3,4,5,6,7,8,9,10])
    print(ret)
    for i in ret:
        print(i)

    模块和包

    模块

    模块(module) 是一个包含 Python 代码的文件,通常以 .py 结尾,模块可以包含变量、函数、类,甚至其他模块。通过模块,我们可以将代码组织成不同的文件,更好地管理和复用代码。

    模块可以分为以下几类:

    • 自定义模块:用户自己编写的模块 .py
    • 标准库模块:Python 自带的模块,如 math、os、sys 等
    • 第三方模块:由其他开发者编写的模块,通常可以通过 pip 安装

    自定义模块

    自定义模块是 Python 中一个重要的代码组织方式,它允许开发者将相关的代码(包括函数、类和变量)封装到一个 .py 文件中。通过自定义模块,我们可以实现代码的重用和模块化开发,避免代码重复,提高代码的可维护性。自定义模块可以被其他 Python 程序通过 import 语句导入使用,每个模块都有自己独立的命名空间,这样可以避免不同模块之间的命名冲突

    示例1:自定义模块

    # my_module.py
    
    print("This is my moudle....")
    
    def greet(name):
        return f"Hello, {name}!"
    
    def add(a, b):
        return a + b
    
    PI = 3.14159
    
    # test.py
    import my_module
    
    # 使用 my_module 中的函数和变量
    print(my_module.PI)
    print(my_module.greet("EaglesLab"))
    print(my_module.add(5, 3))
    
    # 模块别名
    import my_module as mm
    
    print(mm.greet("EaglesLab"))

    示例2:根据用户输入导入不同自定义模块

    # mysql.py
    def sqlparse():
        print('from mysql sqlparse')
    
    # oracle.py
    def sqlparse():
        print('from oracle sqlparse')
    
    # test.py
    db_type = input('>>: ')
    if db_type == 'mysql':
        import mysql as db
    elif db_type == 'oracle':
        import oracle as db
    
    db.sqlparse()

    模块导入

    # 导入多个模块1
    import sys
    import os
    import re
    
    # 通过 from 导入模块
    # from filename import function
    from my_module import greet, add
    
    # 覆盖导入模块中的同名函数
    def add():
        pass
    

    ==注意==:导入需要的功能进行,增加可读性,不要一次导入全部


    python 全局变量 __name__,用来控制 .py 文件在不同的应用场景下执行不同的逻辑

    • 当文件被当做脚本执行时:__name__ 等于'__main__'
    • 当文件被当做模块导入时:__name__等于模块名
    def fib(n):
        a, b = 0, 1
        while b < n:
            print(b, end=',')
            a, b = b, a+b
        print()
    
    if __name__ == "__main__":      #  被当作脚本执行
        print(__name__)
        num = input('num :')
        fib(int(num))    
    
    print(globals())

    ==注意==:__name__是区分’主动执行’和’被动导入’的方法

    模块的搜索路径

    Python 在导入模块时会按照一定的顺序搜索模块所在的位置。主要的搜索路径包括:

    1. 当前目录:Python 首先在当前目录下查找要导入的模块
    2. PYTHONPATH环境变量:包含一系列目录名,可以通过设置此环境变量来添加额外的模块搜索路径
    3. 标准库目录:Python 安装时自带的标准库所在的目录
    4. site-packages 目录:第三方模块安装的默认位置

    设置PYTHONPATH环境变量:

    # Linux/macOS
    export PYTHONPATH=/path/to/your/modules:$PYTHONPATH
    
    # Windows
    set PYTHONPATH=C:pathtoyourmodules;%PYTHONPATH%

    注意事项:

    1. 不建议在代码中直接修改 sys.path,最好通过环境变量或==安装包==的方式管理模块路径
    2. 搜索路径的优先级按照 sys.path 列表中的顺序,越靠前优先级越高
    3. 在导入模块时,一旦在某个路径下找到了对应的模块,就会停止搜索

    ==注意==:安装(包)之后会自动配置路径,原理:当执行 pip install 包 ,包会被安装到Python 的site-packages目录,这个目录就存在于sys.path(模块搜索路径)里,sys.path里本来就有site-packages,你只是往里添加了文件(不改sys.path)

    常规安装:往已有目录里放包形成子目录,不改变sys.path目录列表,==列表里的目录是平级关系==

    开发模式安装:自动添加.pth文件相当于一个新目录

    包(Packages)

    Python 包(Package)是一个==包含 __init__.py 文件==的目录,它用于组织和管理相关的Python模块

    包,使得大型项目中的模块组织更加清晰。通过__init__.py显示声明,解释器自动识别为包

    包(目录树:结构)

    文件内容

    #文件内容
    
    # policy.py
    def get():
        print('from policy.py')
    
    # versions.py
    def create_resource(conf):
        print('from version.py: ',conf)
    
    # manage.py
    def main():
        print('from manage.py')
    
    # models.py
    def register_models(engine):
        print('from models.py: ',engine)

    使用 from 导入包

    from 后 import 导入的模块,必须是明确的一个不能带点,否则会有语法错误,如:from a import b.c是错误语法

    from glance.db import models
    from glance.db.models import register_models
    
    models.register_models('mysql')
    register_models('mysql')

    ==注意==:到时候想用哪个模块就导哪个,不用全导入,要精确性。

    绝对导入和相对导入

    绝对导入:太麻烦,不太好

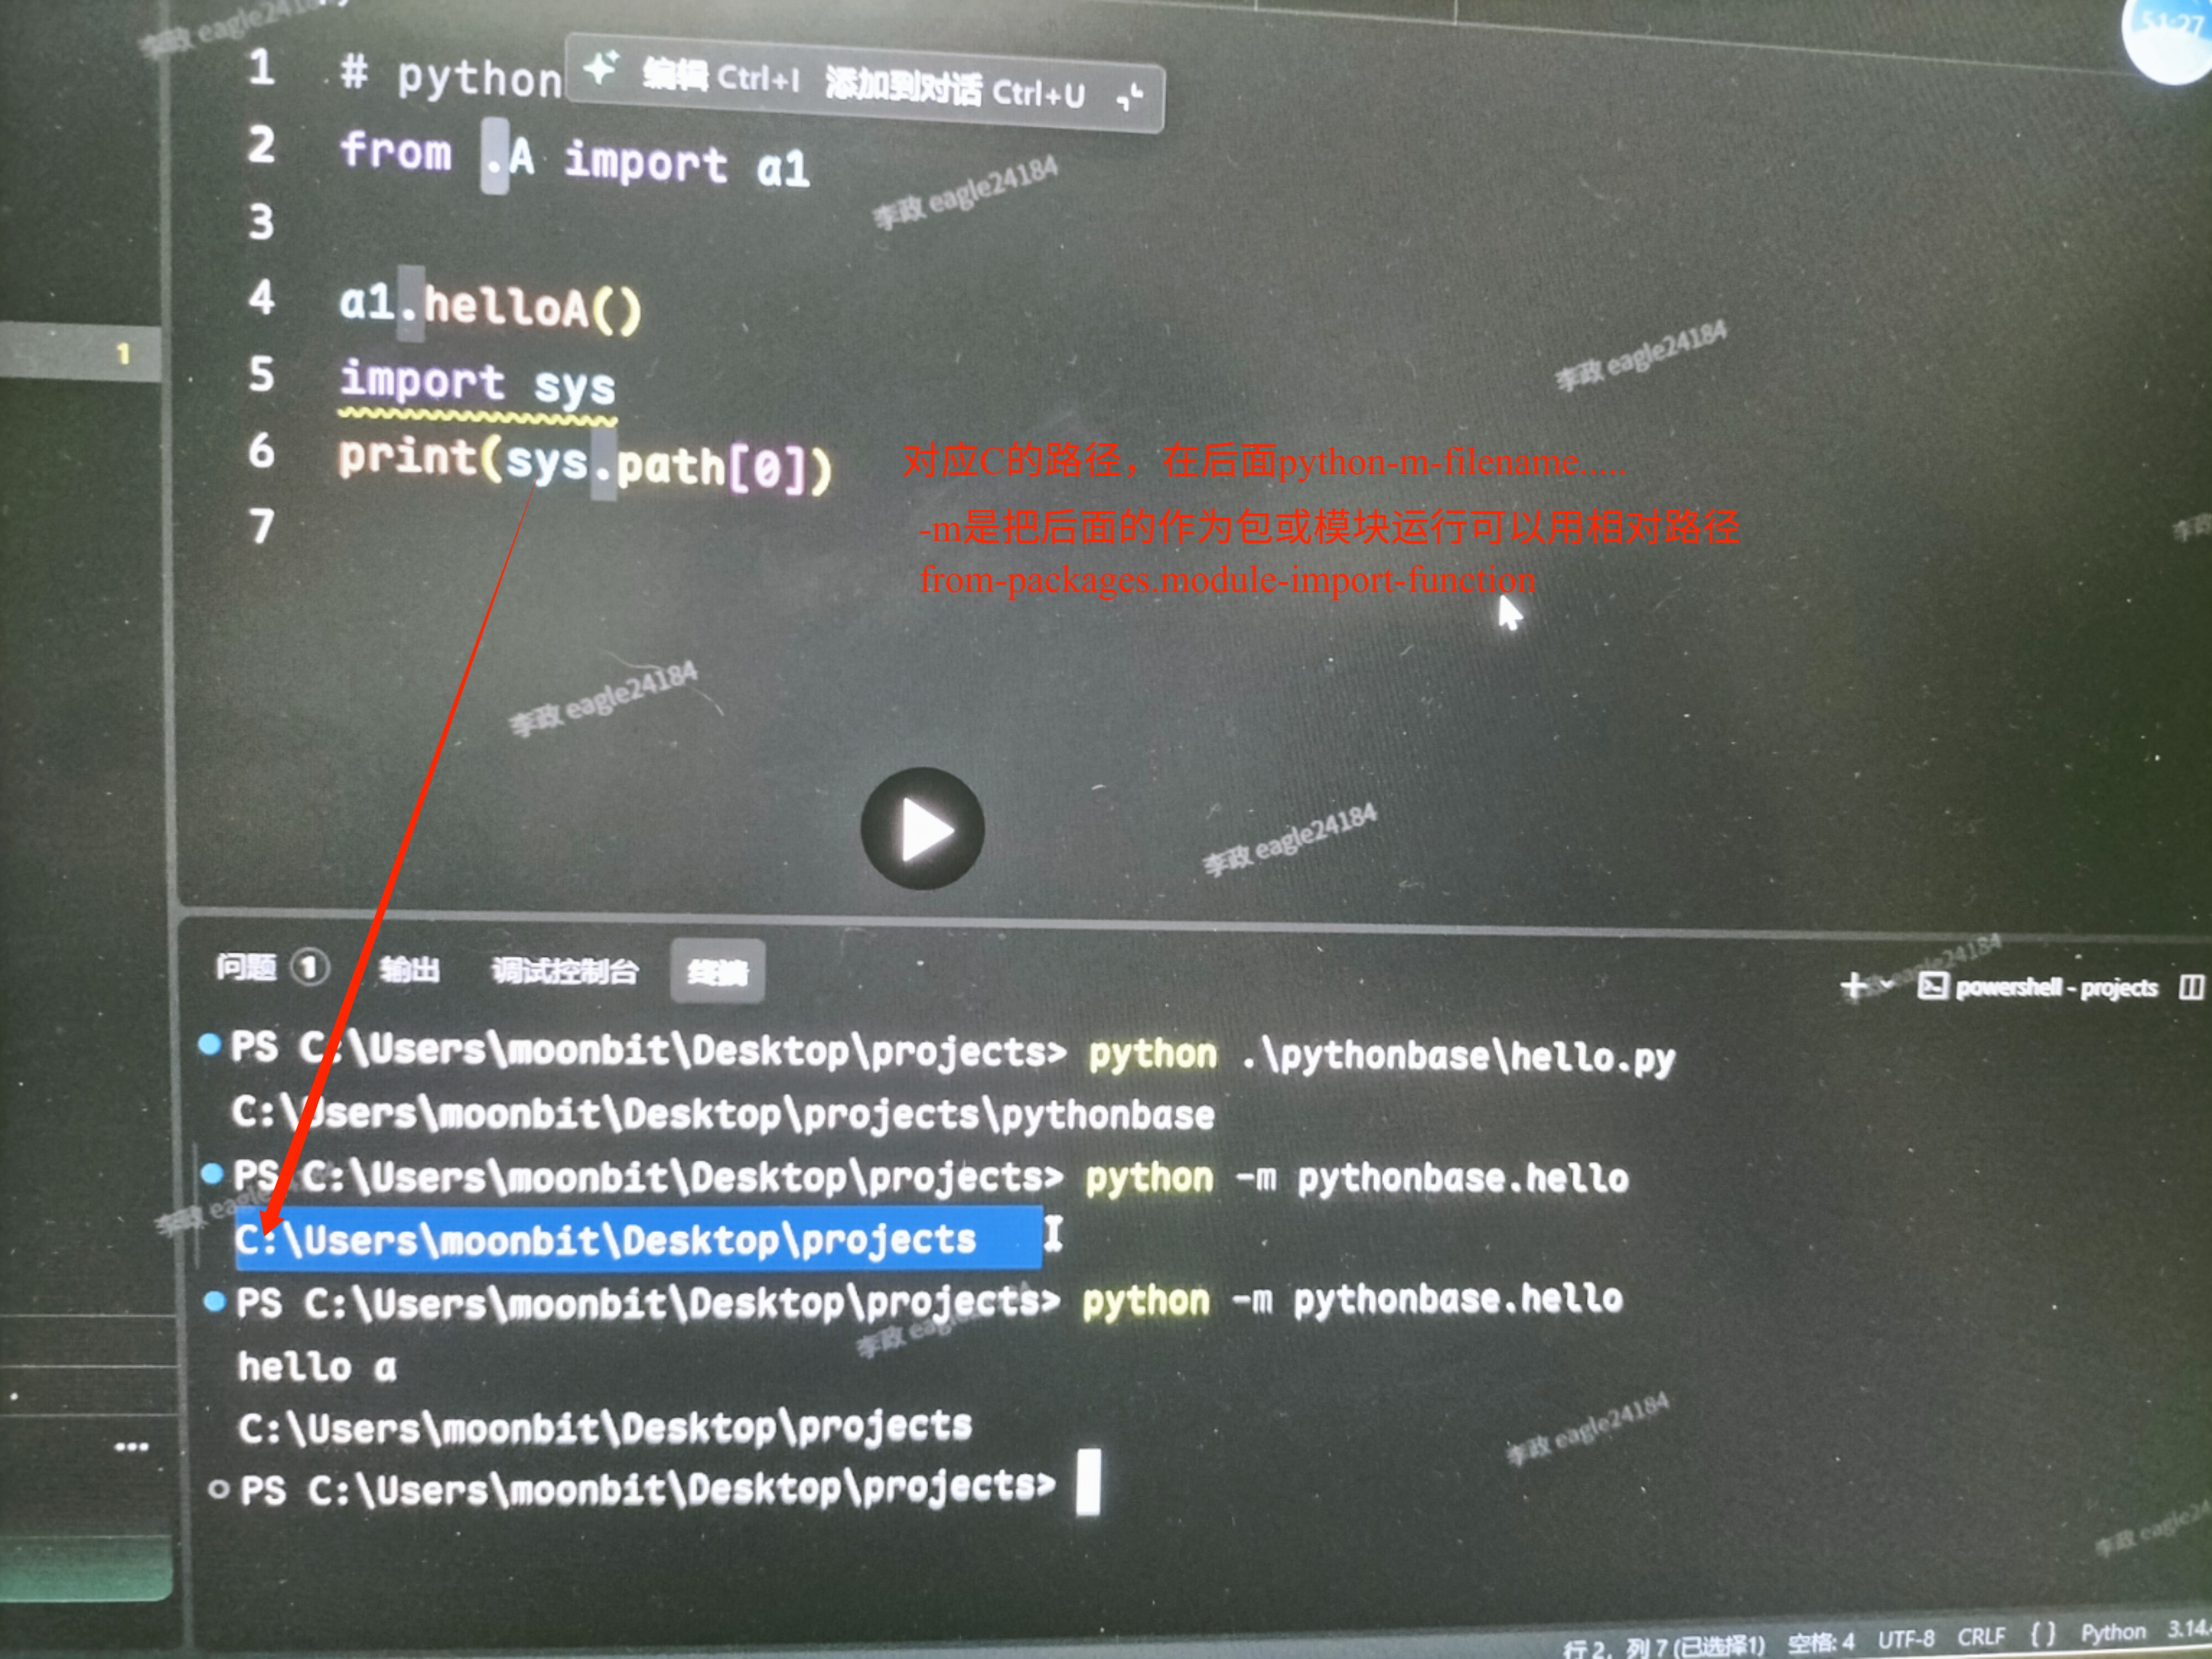
    相对导入:参照sys.path[0]起始开始查找,称之为相对导入

    1. 符号:.代表当前所在文件的文件夹,..代表上一级文件夹,...代表上一级的上一级文件夹
    2. 优点:导入更加简单
    3. 缺点:只能在导入包中的模块时才能使用

    ==注意==:就用python -m packages.module.filename这样可以动态修改

    虚拟环境:包隔离

    通过操作系统路径查找机制,与全局环境隔离。能解决不同包版本冲突问题,全局环境只能安装一个版本,而虚拟环境允许你为每个项目分别安装任意版本,互不干扰。==路径隔离==:为你提供了一个干净、独立、互不干扰的工作空间

    优势

    1. 不同项目依赖同一个包的不同版本时,全局环境只能安装一个,会导致一个项目能跑,另一个项目报错。

    2. 可以直接执行pip命令,全局环境会报错

    3. 项目依赖包和全局依赖包,全局包杂乱无章,虚拟环境项目包独立,互不干扰

    4. 如果不用虚拟环境,全局环境默认路径通常在: · **C:Users你的用户名AppDataLocalProgramsPythonPython3xLibsite-packages** ·或者是 Python 安装目录下的 Libsite-packages 文件夹。

    5. 文件默认安装到系统的全局Python环境,==所以要创建虚拟环境,本质是复制出一套隔离的Python环境,通过优先修改搜索路径sys.path[0],将包安装到项目专属目录而非全局,从而避免不同项目间的版本冲突==


    Python版本隔离:uv

    uv原生支持 Python 版本隔离,uv把 Python 版本锁定在项目内部,即使系统 Python 升级(如 3.10 → 3.12),uv管理的环境也纹丝不动,项目可能遇到不同版本Python

    hashlib模块(算法摘要):加密

    Python 的 hashlib 模块提供了多种安全哈希和消息摘要算法的接口。这些算法用于生成数据的唯一哈希值,广泛应用于数据完整性校验、密码存储等领域

    ==摘要算法==又称哈希算法、散列算法。它通过一个函数,把任意长度的数据转换为一个长度固定的数据串(通常用16进制的字符串表示)。

    摘要算法就是通过摘要函数对任意长度的数据计算出固定长度的摘要,目的是为了发现原始数据是否被人篡改过,进行校验

    摘要算法之所以能指出数据是否被篡改过,就是因为摘要函数是一个单向函数,计算摘要很容易,但通过摘要反推数据却非常困难。而且,对原始数据做一个 bit 的修改,都会导致计算出的摘要完全不同。

    hashlib 支持多种哈希算法,包括:

    算法 说明
    MD5 已破解,不安全,仅用于非安全校验(如文件去重)
    SHA-1 已破解,不安全,已弃用
    ==SHA-256 / SHA-512== 安全,推荐用于通用哈希、数字签名、证书等
    SHA-3 (如 SHA3-256) 新一代安全哈希算法,抗碰撞能力强(Python 3.6+)
    BLAKE2 (blake2b, blake2s) 比SHA-3更快,可选输出长度,同样安全(Python 3.6+)
    SHAKE (128/256) 可扩展输出长度的哈希函数(XOF)(Python 3.6+)
    PBKDF2 密钥派生函数,用于密码存储(通过 hashlib.pbkdf2_hmac 调用)

    基本用法

    import hashlib
    
    # sha256_hash = hashlib.sha256(b'xxxx')
    sha256_hash = hashlib.sha256()   # 创建一个 SHA-256 哈希对象
    md5_hash = hashlib.md5()    
    
    data = b"123456"
    
    sha256_hash.update(data)         #  更新哈希对象
    
    sha256_digest = sha256_hash.hexdigest()    # 获取哈希值
    
    print("SHA-256:", sha256_digest)

    加盐

    import hashlib
    import os
    
    salt = os.urandom(16)   # 生成随机盐
    password = b"123456"
    
    hashed = hashlib.pbkdf2_hmac('sha256', password, salt, 10)  # 使用 sha256 和  10次迭代
    print(hashed)
    
    import binascii
    print(binascii.hexlify(stored_hash).decode('utf-8'))    # 转成十六进制表示

    注意事项

    1. 不可逆性:哈希函数是不可逆的,意味着无法从哈希值恢复原始数据。
    2. 碰撞:不同的输入可能生成相同的哈希值(称为碰撞),但现代的哈希算法力求使碰撞的概率尽量低。
    3. 安全性:对于密码存储,建议使用更安全的哈希算法(如SHA-256 或更高版本)和适当的盐值(salt)来增强安全性。

    使用场景

    • 数据完整性:用于验证文件或数据在传输过程中未被篡改。
    • 密码存储:将用户密码的哈希值存储在数据库中,而不是明文密码。
    • 数字签名:用于创建数字签名,确保数据来源的可靠性。

    案例:密码验证

    import hashlib
    import os
    
    salt = os.urandom(16)
    password = b"123456"
    
    stored_hash = hashlib.pbkdf2_hmac('sha256', password, salt, 10)
    
    def verify_password(stored_hash, stored_salt, input_password):
        new_hash = hashlib.pbkdf2_hmac('sha256', input_password, stored_salt, 10)
        return new_hash == stored_hash
    
    pwd = bytes(input('input passwrod: '), encoding='utf-8')
    
    print(verify_password(stored_hash, salt, pwd))

    ==注意==:校验:密码哈希值匹配密码哈希值

    ​ 密码串已生成一次摘要,再通过二次加盐拼进去一个随机串,进行二次摘要

    ​ md5有对应库进行比对,只能比对简单的

    密码验证原理

    每个软件都有自己独立的数据库,这个独立的数据库存储了 每个人的用户名(明文)、盐(用户固定唯一的),迭代次数(一般软件开发者自动设置为一个固定参数比如10000),哈希值(根据用户名,密码,盐,迭代次数生成的 ),==密码==不会存储在数据库

    ==攻击者==:如果数据库泄露了,攻击者可以==拿到数据库的用户(某些或全部)存储信息==,然后可以通过软件不断试密码,这个过程叫:==离线暴力破解==或==离线字典攻击==;有坏情况试出来密码也没事,很多支付软件(银行app,支付宝…)有双重认证(2FA)比如(指纹,人脸识别什么的)

    ==总结==:加盐+哈希保护的是存储安全,双重认证保护的是 . 两者结合,即使数据库泄露且你的密码被破解,攻击者仍然无法进入你的账户

    撞库:

    定义:攻击者利用从一处泄露得到的用户名和明文密码,批量尝试登录其他网站或服务。

    典型流程:

    1. 攻击者从网站 A 的泄露数据库中得到一批用户名和密码(例如通过离线破解哈希获得明文)。
    2. 然后编写脚本,用这些组合去尝试登录网站 B、网站 C、邮箱、银行等。
    3. 由于许多用户在多个平台使用相同的密码,撞库成功率往往不低。

    ==例如==:银行支付有二次验证,QQ新设备/异常位置时都有二次验证

    re正则模块

    贪婪和非贪婪:贪婪:吃到最后一个满足条件的;非贪婪:吃到第一个满足条件的就停

    ==注意==:正则表达式用ai写出来会用就行

  • Python网络编程

    计算机组成

    cpu(中央处理器):负责执行所有程序的指令,现代cpu都是多核的。==单核运行==:操作系统把你的程序分配给一个核心,即使CPU有8个核,你的程序也只占一个。多核运行:程序内部拆成多个可独立执行的任务,操作系统把它们调度到不同核心上同时执行,真正并行处理,能成倍缩短计算时间

    内存:是cpu和硬盘间的缓冲地带,存放当前运行的程序和需处理的数据。它是易失性存储,断电后数据全部丢失. ==内存条==(DRAM动态内存),直接与CPU通过内存总线交换数据,速度远快于硬盘,但慢于CPU cache

    硬盘:永久仓库,断电不丢失数据,SSD(固态硬盘):主流,电路读写,安静,无机械部件. 作用:长期存放操作系统、应用程序和用户的文档、照片、视频等所有文件。当要运行时,数据会先从硬盘加载到内存,再由CPU处理

    显卡(GPU):视觉输出处理器,图形渲染输出画面,NVIDIA,可进行大规模并行计算

    主板:一块集成了各种插槽和接口的巨大电路板,功能:为所有硬件提供物理安装平台和数据与通信通道. 包含:1.芯片组,主板的”交通枢纽”,负责管理数据在CPU,内存,显卡,硬盘,USB接口之间的流通. 2.插槽与接口:提供CPU插槽、内存插槽、PCIe扩展槽、硬盘接口、USB接口等. 3.BIOS/UEFI:主板上固化的最底层程序,负责开机硬件自检、初始化,并引导操作系统

    电源:为计算机各部件提供电流

    散热器:负责将CPU和GPU这些发热大户产生的热量迅速带走,防止因为过热而降频或损坏。一般涂抹导热硅脂来填平肉眼不可见的缝隙,否则散热效果会大打折扣

    计算机组成示意图

    ![](Python网络编程.assets/计算机组成示意 (2).png)

    工作原理:开机,电源供电,主板初始化,CPU从硬盘加载系统到内存运行. 程序图形指令发给显卡生成画面。散热器散热

    操作系统

    操作系统:(Operating System,简称 OS)是管理和控制计算机硬件与软件资源的计算机程序,是直接运行在“裸机”上的最基本的系统软件,任何其他软件都必须在操作系统的支持下才能运行

    操作系统应该分成两部分功能

    1. 隐藏了丑陋的硬件调用接口(键盘、鼠标、音箱等等怎么实现的,就不需要你管了),为应用程序员提供调用硬件资源的更好,更简单,更清晰的模型(系统调用接口)。应用程序员有了这些接口后,就不用再考虑操作硬件的细节,专心开发自己的应用程序即可。 例如:操作系统提供了文件这个抽象概念,对文件的操作就是对磁盘的操作,有了文件我们无需再去考虑关于磁盘的读写控制(比如控制磁盘转动,移动磁头读写数据等细节)
    2. 将应用程序对硬件资源的竞态请求变得有序化 例如:很多应用软件其实是共享一套计算机硬件,比方说有可能有三个应用程序同时需要申请打印机来输出内容,那么a程序竞争到了打印机资源就打印,然后可能是b竞争到打印机资源,也可能是c,这就导致了无序,打印机可能打印一段a的内容然后又去打印c…,操作系统的一个功能就是将这种无序变得有序。

    image-20260525095923851

    ​ IO子系统(珊瑚色):把磁盘、SSD的复杂块操作统一成 read/write/open 几个调用

    ​ 内存管理(蓝色):MMU+ 页表把物理 RAM 变成每个进程独享的虚拟地址空间

    ​ 图形子系统(琥珀色):DRM/帧缓冲层隔离 GPU 差异,OpenGL/Vulkan 再往上抽象一层

    ​ 网络协议栈(青色):Socket API把 TCP/IP/以太网/WiFi的协议细节全部收进内核

    ​ 输入设备(粉色):evdev/HID 把键盘、鼠标、触摸板、手柄统一成事件队列

    ==总结==:自上而下的主要关系: 1. 应用程序层(最上层):浏览器、游戏等软件只与“系统调用接口”交互,无需直接操作硬件。 2. 系统调用接口:为上层提供统一入口(如 read、open),隔离了具体硬件实现。 3. 内核子系统(中间核心层): · IO子系统、内存管理、图形子系统、网络协议栈、输入设备 各自负责一类资源 · 它们通过设备驱动层与底层硬件通信 4. 设备驱动层:每个驱动程序对应一类硬件(如磁盘驱动、网卡驱动),负责将内核的通用操作转换为硬件具体指令。 5. 硬件层(最底层):实际的物理设备(磁盘、内存、GPU、网卡、键盘等)。 核心关系逻辑: 向下屏蔽差异:驱动层让内核子系统无需关心不同厂商硬件的细节 ,向上提供抽象:系统调用给应用程序简洁的接口(比如“文件”抽象了磁盘读写) · 横向协调资源:各子系统内部会管理多个应用的竞争请求(如打印机有序打印),将无序变得有序

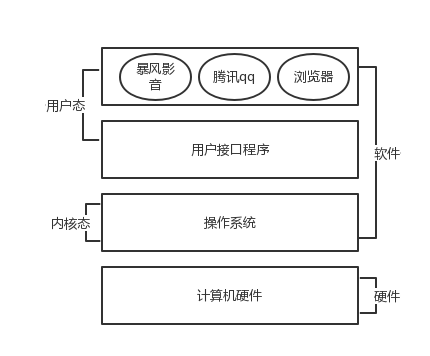
    用户态和内核态

    主要区别在于==能不能执行特权指令==


    ==提权==:正常情况:用户态程序如果没通过权限检查,内核会直接拒绝,无法获得内核态高权限。

    ​ 恶意提权:利用漏洞,即使没通过检查,也能让内核态执行高权限操作(如修改进程凭证为 root),从而获得本不该有的高权限

           1. 正常提权:检查通过 → 合法获得高权限

    ​ 2.恶意提权:检查被绕过 → 非法获得高权限

    网络基础知识

    OSI七层模型

    image-20260525112023506

    OSI是理论标准,TCP/IP是事实标准,五层是工程和教学的折中,更常用,每一层的==唯一标识==如下:

    ​ 数据链路层——MAC地址 机器A:MAC AA:AA:AA:AA:AA:AA,交换机

    ​ 网络层——IP地址 (192.168.1.10)(局域网1),路由器

    ​ 传输层——端口号 (80),HTTP(网页),操作系统

    ​ 应用层——PID(2345)或(5678),自己写的程序

    简单路由器示例

    img

    img

    ==总结==: 1.每个网络接口(网卡)都有一个出厂固定的MAC地址。路由器有多个接口(比如LAN口、WAN口),所以它有多个不同的MAC地址,每个接口一个。你电脑上如果只有一个有线网卡和一个Wi-Fi网卡,那就有两个不同的MAC地址

    ​ 2.TCP是协议,端口是TCP头部里的一个字段。==TCP用端口来区分进程(运行的应用程序,如QQ,微信,音乐,b站视频)==:告诉接收方的操作系统,数据应该交给哪个应用程序 。 端口的核心作用:当数据包经过IP和MAC地址送到正确的电脑后,端口负责把数据交给正确的进程。

    ​ 3.电脑MAC → 路由器入口MAC → 路由器出口MAC → 目标MAC

    私有地址和公有地址

    1. 私有地址之间不能直接传输,只有公有可直接传输
    2. 所以,“公有 IP+ 临时端口” 就是两个私有设备之间的桥梁。 没有这个中间态,数据包无法穿越 NAT 到达私有设备
    3. NAT 路由器只记录内网设备主动访问外网(公有地址)时建立的==映射==
    4. 私有设备之间的直接通信,并不是私有地址到私有地址,而是 私有地址A(私有ip+固有端口) → 自己的(公有IP+临时端口A) → 对方的(公有IP+临时端口B) → 私有地址B(私有ip+固定端口),==所以是通过这个NAT建立的映射保存记录来实现传输的==

    具体工作协同流程

    1. 发送方(A)
      数据从应用层往下走:TCP加端口(保可靠、找进程) →IP加地址(最终目的) → MAC加下一站地址(当前链路)。
      封装完成,发出去。
    2. 路由器(B)
      收包后只剥MAC头,看IP决定下一跳,然后重写MAC头(源变自己出口,目标变下一站)。
      IP和TCP头原封不动。
    3. 接收方(C)
      从下往上逐层剥头:MAC匹配自己 →IP匹配自己 → 按TCP端口交给对应进程(如Web服务)。
      若数据完整有序,则应用层收到原始数据。

    核心规则:

    · IP全程不变(最终地址) · MAC每跳更换(逐段寻路) · 端口固定(区分进程) · TCP保证可靠(不丢、不乱、不错) · 封装与解封装顺序严格相反(加头→去头)

    代码示例

    域名系统(dns)

    域名系统的本质:一个分布式,层次化的命名与映射系统。==把人类易记的域名==(如baidu.com)==转换成机器寻址用的IP地址==

    (如110.242.68.66) . 用直观的英文单词(baidu.com域名)DNS协议自动返回 ip (110.242.68.66)

    网络编程可操作的层:

    对于开发者来说,我们只能站在==应用层==做操作,一般以下面两个任务为主 1.基于HTTP协议做客户端和服务端开发(非常非常高频,Java后端和web前端以HTTP协议为核心) 2.基于socket开发应用层协议和解析应用层协议(很少很少接触到,一般在中间件或基础软件研发才会接触到)

    Socket网络编程

    实际上从传输层开始以及以下,都是操作系统帮咱们完成下面的各种包头封装的过程

    ![](img-socket抽象层

    ==Socket的本质和革命性意义==

    本质: Socket是操作系统提供给用户进程的、对网络通信端点的一个抽象。 它把复杂的TCP/IP协议栈(三次握手、滑动窗口、拥塞控制、重传、校验等)封装成一组简单的、类似文件操作的API(socket, bind, listen, accept, connect, send, recv)。

    意义:


    核心概念

    • Socket(套接字):网络通信的端点,支持不同主机间的进程通信
    • 协议类型:
      • TCP:
      • UDP:
    • 地址族:…

    TCP 协议工作流程

    image-20260526005654658

    服务端

    实现步骤:

    1. 创建 Socket 对象:socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    2. 绑定地址与端口:bind(('0.0.0.0', 12345))(0.0.0.0 表示监听所有 IP)
    3. 监听连接:listen(5) (参数为最大等待连接)
    4. 接收连接:accept() 返回客户端 Socket 和地址
    5. 数据交换:send() 和 recv() 方法收发数据
    6. 关闭连接:close() 释放资源

    客户端

    实现步骤:

    1. 创建 Socket 对象:socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    2. 连接服务器:connect(('127.0.0.1', 12345))
    3. 数据交换:同服务器端 send() 和 recv()

    示例代码

    # server.py 代码
    import socket
    
    server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    
    server.bind(("127.0.0.1", 8080))
    
    server.listen(5)
    
    conn, client_addr = server.accept()
    print(conn, client_addr, sep="n")
    
    from_client_data = conn.recv(1024)
    print(from_client_data.decode("utf-8"))
    
    conn.send(from_client_data.upper())
    
    conn.close()
    
    server.close()
    
    
    # client.py 代码
    import socket
    
    client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    
    client.connect(("127.0.0.1", 8080))
    
    client.send("hello".encode("utf-8"))
    
    from_server_data = client.recv(1024)
    
    print(from_server_data)
    
    client.close()

    TCP与UDP协议区别

    1. TCP是可靠传输协议(稳定可靠): 用于网页浏览,文件传输,电子邮件,数据库连接;UDP是不可靠传输协议(会偶尔丢包,追求低延迟):游戏,实时音视频,直播(虎牙,b站等)

    粘包问题

    ==原因==:

    发送方、接收方 和 两个维度分解。

    1. 发送方原因:TCP 协议栈的优化行为

    • Nagle 算法(默认开启):
      为了减少小包数量,TCP 会等待一小段时间(通常 200ms),如果发送缓冲区中有多个小消息,或者等待期间收到了之前消息的 ACK,就会将多个小消息合并成一个 TCP 段发出。
      → 导致:多个应用层消息粘在一起(粘包)。
    • 最大分段大小(MSS)限制:
      TCP 段的数据部分不能超过 MSS(通常由路径 MTU 决定,典型值 1460 字节)。如果一个应用层消息大于 MSS,TCP 会将其拆分成多个段。
      → 导致:一个消息被分成多次发送(拆包)。
    • 发送缓冲区策略:
      应用程序 write 的数据先复制到内核发送缓冲区。TCP 会按照自身的拥塞控制和流量控制来决定何时真正发送、发送多少。即使你分两次 write,也可能被一次性发出。

    2. 接收方原因:应用程序读取不及时

    • 接收缓冲区堆积:
      内核将收到的 TCP 段存入接收缓冲区。如果应用程序调用 recv 不够快,多个消息就会堆积在缓冲区中。当应用程序最终调用 recv 读取一个大块时,可能一下子取走多个消息。
      → 导致:粘包。
    • 用户缓冲区长度限制:
      调用 recv(buf, len) 时,若 len 小于消息的实际长度,则只能读出部分数据,剩余数据留在缓冲区中。下次再读时,可能读到某个消息的后半部分,或者读到下一个消息的前半部分。
      → 导致:拆包(也叫半包)。

    ==本质==

    TCP 是面向字节流的协议,它只保证字节序列的有序、可靠传输,但不维护、不识别应用层消息之间的边界。 因此,多个应用层消息在字节流中可能“粘”在一起,也可能一个消息被拆成多个片段,“粘包”和“拆包”是同一本质的两种表现形式。

    解决方案

    一.直接使用已封装好消息边界的库/协议

    不直接操作裸 Socket,而是==选用已经内置了粘包处理能力==的:

    image-20260608100253598

    二、为什么使用(原因)


    三.优点(使用带来的好处)

    image-20260608100431720

    ==总结==:使用现成库/协议解决粘包,就是用“行业标准方案”替代“手写轮子”,换来高效率、高可靠、低维护成本的工程收益。在实际项目中,除非有极轻量的私有协议需求,否则这永远是首选做法。


    示例代码

    Demo1

    通过 连续发送小数据包 和 接收缓冲区合并 的场景模拟粘包现象:

    # 服务端代码(连续发送两次数据)
    import socket
    
    server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    server.bind(('0.0.0.0', 8888))
    server.listen(5)
    
    print("服务端已启动,等待客户端连接...")
    
    conn, addr = server.accept()
    print(f"客户端 {addr} 已连接")
    
    try:
        # 连续发送两次数据(未处理粘包)
        conn.send(b'Hello')  # 第一次发送
        conn.send(b'World')  # 第二次发送(可能合并到缓冲区)
    except KeyboardInterrupt:
        print("服务端主动终止")
    finally:
        conn.close()
        server.close()
    
    # 客户端代码(一次性接收数据)
    
    import socket
    
    client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    client.connect(('127.0.0.1', 8888))
    
    try:
        # 一次性接收数据(可能合并两次发送的内容)
        data = client.recv(1024)
        print(f"接收到的数据: {data.decode()}")  # 预期输出可能是 'HelloWorld'
    except ConnectionResetError:
        print("服务端已关闭连接")
    finally:
        client.close()

    现象解释

    1. Nagle 算法:发送端连续调用 send() 发送小数据包,可能将两次发送合并为一个包。
    2. 缓冲区机制:接收端 recv(1024) 的缓冲区较大,一次性读取了所有待接收数据

    Demo2

    通过 大缓冲区发送 + 小缓冲区接收 的场景模拟接收不完整问题:

    # 服务端代码(发送 10KB 大数据包)
    import socket
    
    server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    server.bind(('0.0.0.0', 8888))
    server.listen(5)
    
    print("服务端已启动,等待客户端连接...")
    conn, addr = server.accept()
    
    try:
        # 发送 10KB 数据(超过常规接收缓冲区)
        big_data = b'A' * 1024 * 10  # 10KB
        conn.sendall(big_data)
        print(f"已发送 {len(big_data)} 字节数据")
    except KeyboardInterrupt:
        print("服务端主动终止")
    finally:
        conn.close()
        server.close()
    
    # 客户端代码(仅接收 4KB 数据)
    import socket
    
    client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    client.connect(('127.0.0.1', 8888))
    
    try:
        # 设置接收缓冲区为 4KB,且仅接收一次
        partial_data = client.recv(4096)  # 只接收一次
        print(f"实际接收长度: {len(partial_data)} 字节")  # 输出 4096,残留 6KB 未接收
    except ConnectionResetError:
        print("服务端已关闭连接")
    finally:
        client.close()

    现象解释

    1. TCP 流式特性:TCP 将数据视为连续字节流,无边界标识
    2. 缓冲区限制:recv() 方法一次性读取的字节数受参数限制,未循环接收导致残留

    struct模块

    把一个类型,如数字,转成固定长度的 bytes

    常见用法

    import struct
    
    # 将一个数字转化成等长度的bytes类型。
    ret = struct.pack('i', 18334)
    print(ret, len(ret))
    
    # 通过unpack反解回来 返回一个元组回来
    ret1 = struct.unpack('i',ret)[0]
    print(ret1)

    Demo1

    # 服务端代码(连续发送两次数据)
    import socket
    import struct
    
    server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    server.bind(('0.0.0.0', 8888))
    server.listen(5)
    
    print("服务端已启动,等待客户端连接...")
    
    conn, addr = server.accept()
    print(f"客户端 {addr} 已连接")
    
    try:
        data = b'Hello'
        header = struct.pack("!I", len(data))
        conn.send(header + data)  # 第一次发送
        data = b'World'
        header = struct.pack("!I", len(data))    
        conn.send(header + data)  # 第二次发送
    except KeyboardInterrupt:
        print("服务端主动终止")
    finally:
        conn.close()
        server.close()
    
    # 客户端代码
    import socket
    import struct
    
    client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    client.connect(('127.0.0.1', 8888))
    
    try:
        # 接收固定长度包头
        header = client.recv(4)
        data_size = struct.unpack("!I", header)[0]
        received_data = client.recv(data_size)
        print(f"实际接收长度: {len(received_data)} 字节")
        print(received_data)
    except ConnectionResetError:
        print("服务端已关闭连接")
    finally:
        client.close()

    Demo2

    # 服务端代码(发送 10KB 大数据包)
    import socket
    import struct
    
    server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    server.bind(('0.0.0.0', 8888))
    server.listen(5)
    
    print("服务端已启动,等待客户端连接...")
    conn, addr = server.accept()
    
    try:
        # 发送 10KB 数据
        big_data = b'A' * 1024 * 10  # 10KB
        # 发送固定长度包头
        header = struct.pack("!I", len(big_data))
        conn.sendall(header + big_data)
        print(f"已发送 {len(big_data)} 字节数据")
    except KeyboardInterrupt:
        print("服务端主动终止")
    finally:
        conn.close()
        server.close()
    
    
    #  客户端代码
    import socket
    import struct
    
    client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    client.connect(('127.0.0.1', 8888))
    
    try:
        # 接收固定长度包头
        header = client.recv(4) 
        data_size = struct.unpack("!I", header)[0]
        # 接收完整数据
        received_data = b""
        while len(received_data) < data_size:
            remaining = data_size - len(received_data)
            chunk = client.recv(min(remaining, 1024))
            if not chunk:
                break
            received_data += chunk
        print(f"实际接收长度: {len(received_data)} 字节")
    
    except ConnectionResetError:
        print("服务端已关闭连接")
    finally:
        client.close()

    HTTP协议

    HTTP(HyperText Transfer Protocol,超文本传输协议)是用于在客户端(通常是浏览器)和服务器之间传输超文本(如HTML)的应用层协议.它是无状态的、面向请求-响应的协议,基于TCP/IP传输。

    HTTP有不同版本号:

    • HTTP1.1:支持持久连接(长连接),一个 TCP 连接允许多个请求,新增 PUT、PATCH、DELETE 等
    • HTTP2.0:性能大幅提升,新的二进制格式,多路复用,header 压缩,服务端推送

    HTTP 工作原理

    HTTP的工作过程可以总结为以下几个步骤:

    1. 建立连接: 客户端(如浏览器)与服务器之间通过TCP三次握手建立连接
    2. 发送请求: 客户端向服务器(Apache、Nginx、IIS服务器)发送HTTP请求报文,请求资源或操作
    3. 服务器处理请求: HTTP服务器接收到请求后,处理请求并生成响应
    4. 返回响应: 服务器将响应报文返回给客户端
    5. 断开连接: 通常在响应完成后关闭TCP连接

    URL 与 URI

    URI(Uniform Resource Identifier)

    URI 是统一资源标识符,用于标识互联网上的资源,URI 分为两种:

    • URL(Uniform ResourceLocator): 统一资源定位符,用于描述资源的地址。
    • URN(Uniform Resource Name): 统一资源名称,用于标识资源的名称,不依赖物理位置

    URL(Uniform Resource Locator)

    HTTP 使用统一资源标识符(Uniform Resource Identifiers, URI)来传输数据和建立连接。URL 是一种特殊类型的URI,包含了用于查找某个资源的足够的信息

    URL 全称是 UniformResourceLocator, 中文叫统一资源定位符,是互联网上用来标识某一处资源的地址。以下面这个URL为例,介绍下普通URL的各部分组成:

    http://iproute.cn:80/news/search?keyword=123&enc=utf8#name=321

    从上面的URL可以看出,一个完整的URL包括以下几部分:

    1. 协议部分: 该URL的协议部分为 http:,这代表网页使用的是HTTP 协议。在 Internet 中可以使用多种协议,如 HTTP,FTP 等等本例中使用的是 HTTP 协议。在 http: 后面的 // 为分隔符
    2. 域名(主机)部分: 该 URL 的域名部分为 iproute.cn。一个URL 中,也可以使用 IP 地址作为域名使用
    3. 端口部分: 跟在域名后面的是端口,域名和端口之间使用 : 作为分隔符。端口不是一个 URL 必须的部分,如果省略端口部分,将采用默认端口
    4. 虚拟目录部分: 从域名后的第一个 / 开始到最后一个 / 为止,是虚拟目录部分。虚拟目录也不是一个 URL 必须的部分。本例中的虚拟目录是 /news/
    5. 文件名部分: 从域名后的最后一个 / 开始到 ? 为止,是文件名部分,如果没有 ? ,则是从域名后的最后一个 / 开始到 # 为止,是文件部分,如果没有 ? 和 #,那么从域名后的最后一个 / 开始到结束,都是文件名部分。本例中的文件名是 search 。文件名部分也不是一个 URL 必须的部分,如果省略该部分,则使用默认的文件名
    6. 参数部分: 从 ? 开始到 # 为止之间的部分为参数部分,又称搜索部分、查询部分。本例中的参数部分为 keyword=123&enc=utf8。参数可以允许有多个参数,参数与参数之间用 & 作为分隔符
    7. 锚部分: 从 # 开始到最后,都是锚部分。本例中的锚部分是name。锚部分也不是一个 URL 必须的部分

    HTTP 请求报文

    客户端发送一个 HTTP 请求到服务器的请求消息包括以下格式:

    ==注意==:HTTP请求报文本质上就是一个符合HTTP协议规范的==’长字符串’==,所以我们应用层(用户层)的任务是:只需构造按照HTTP格式的纯字符串,剩下的TCPIP协议的封装与传输全部由操作系统内核自动完成

    如何构造请求报文

    通常有自己==手动拼接==和==使用库==两种方式

    1. 手动拼接:需要严格遵循HTTP报文的格式:
    GET /user?name=Tom HTTP/1.1rn
    Host: example.comrn
    Connection: closern
    rn
    1. 使用编程语言的第三方库(Python的request库)
    import requests
    response = requests.get('http://example.com/user', params={'name': 'Tom'})
    # 实际发送的字符串由 requests 库自动生成

    POST 和 GET 请求方法区别

    • 提交的过程
      • GET 提交,请求的数据会附在URL之后(就是把数据放置在 HTTP 协议头中),以?分割URL和传输数据,多个参数用&连接
      • POST 提交:把提交的数据放置在是HTTP包的包体中
    • 传输数据的大小
      • 首先声明:HTTP协议没有对传输的数据大小进行限制,HTTP 协议规范也没有对URL长度进行限制
      • GET 提交,特定浏览器和服务器对URL长度有限制
      • POST 提交,由于不是通过URL传值,理论上数据不受限
    • 安全性
      • POST 的安全性要比 GET 的安全性高
      • 登录页面有可能被浏览器缓存,而缓存的是 URL
      • 其他人查看浏览器的历史纪录,那么别人就可以拿到你的账号和密码
      • 使用 GET 提交数据还可能会造成 Cross-site request forgery 攻击

    HTTP 响应报文

    服务的相应信息格式如下:

    HTTP状态码

    • 状态代码有三位数字组成,第一个数字定义了响应的类别,共分五种类别:
      • 2xx:成功–表示请求已被成功接收、理解、接受
      • 4xx:客户端错误–请求有语法错误或请求无法实现
      • 5xx:服务器端错误–服务器未能实现合法的请求
    • 常见状态码
    200 OK                        //客户端请求成功
    404 Not Found                 //请求资源不存在,eg:输入了错误的URL
    500 Internal Server Error     //服务器发生不可预期的错误

    HTTP请求方法

    根据 HTTP 标准,HTTP 请求可以使用多种请求方法。

    HTTP1.1 新增了五种请求方法:OPTIONS, PUT, DELETE, TRACE 和 CONNECT 方法。

    • ==GET==:请求指定的页面信息,并返回实体主体。
    • HEAD:类似于 get 请求,只不过返回的响应中没有具体的内容,用于获取报头
    • ==POST==:向指定资源提交数据进行处理请求(例如提交表单或者上传文件)。数据被包含在请求体中。POST请求可能会导致新的资源的建立和/或已有资源的修改。
    • PUT:从客户端向服务器传送的数据取代指定的文档的内容。
    • DELETE:请求服务器删除指定的页面。
    • ·CONNECT:HTTP/1.1协议中预留给能够将连接改为管道方式的代理服务器。
    • OPTIONS:允许客户端查看服务器的性能。
    • TRACE:回显服务器收到的请求,主要用于测试或诊断。

    长连接与短连接

    HTTP1.1规定了默认保持长连接(HTTP persistent connection ,也有翻译为持久连接),数据传输完成了保持TCP连接不断开(不发RST包、不四次握手),等待在同域名下继续用这个通道传输数据;相反的就是短连接。

    在实际使用中,HTTP 头部有了 Keep-Alive 这个值并不代表一定会使用长连接,客户端和服务器端都可以无视这个值,也就是不按标准来。毕竟 TCP 是一个双向连接的协议,双方都可以决定是不是主动断开。

    客户端的长连接不可能无限期的拿着,会有一个超时时间,服务器有时候会告诉客户端超时时间。下图中的 Keep-Alive: timeout=20,表示这个TCP通道可以保持20秒

    HTTP协议实践

    Repable(Proxy):抓包工具

    ==本质==:Proxy是代理服务器的意思,可通过这个代理服务器抓包

    抓包原理:请求发出去发给==代理服务器==,由==代理服务器软件==再发给百度,百度返回给软件,软件返回给浏览器,相当于==中间介入一个伪服务器==

    Reqable在安装时主动把ssl根证书勾选就是可以主动把https里加密的s以明文的方式解析出来,如果没有就只像wireshark这种通过物理层的抓包,S解析不出来,必须主动添加密钥

    百度浏览器抓包示例

    先在浏览器里输入www.baidu.com发送HTTP请求报文

    服务器返回响应并经浏览器渲染成百度页面

    image-20260526232948117

    抓包原理


    ==总结==:响应体是数据,响应头是指令,浏览器按指令处理数据.

    Deepseek请求报文

    用编程的方式和Deepseek交流

    image-20260526233707670

    ==总结==:用Repable发送请求报文

    1. 需要在请求头中添加键值对,键为Authorization,值为Bearer Token(api.keys),就可发送报文,==授权相关的字段==都放在请求头上
    2. URL和请求体. URL(含路径和查询参数):适合放==简短、非敏感的数据== ;请求体(Body):适合放较大、结构复杂、敏感的(JSON对象,文件二进制流,可上传GB级文件)

    Python创建请求报文

    ![](Python网络编程.assets/Python请求报文 (2).jpeg)

    ![](Python网络编程.assets/Python请求报文 (3).jpeg)

    请求报文总结

    对于服务端开发来说通过URL不同路径区分不同业务类型,得到不同功能数据

    ==本质==:对于不同接口文档,看接口文档授权参数是什么比如(Deepseek的是Authorization)然后后面是Token(API密钥)

    http.client使用

    URL中的中文编码

    image-20260527090157712

    ==注意==:URL不能直接传中文,必须将中文变成URL编码

    开代理服务器:配合抓包服务器抓包

    ==抓包==:开代理服务器,配合抓包软件抓包

    Body传输

    ==Body传输==:基本都是以json字符串形式

    文件传输二进制

    直接放进去

    ==注意==:文件要以二进制形式直接传进Body

    Multipart格式

    用虚拟环境装第三方包

    Python第三方库(自动转为对应格式)

    ==总结==:改方法就改request后面函数名(get或post),改路径就改URL,改请求头就改headers后面的字典(授权,和token),改路径里的查询参数就改params后面,

    要是想要请求体生成对应类型就直接打开文件或将任意数据写在开始构造请求体的response里用(json,data,或者打开文件或者file)自动转为对应请求体格式

    ==传输原理==: 普通参数(headers、params、data、json)基本都用字典(json也可以传列表)。 · 文件上传不能用 data 或 json,必须用 files 参数,并且传入的是文件对象(或者按规则构造的元组),而不是文件名字符串。

    参数       常见类型                                         说明
    headers   字典 {key:value,key:value}                       键值对,如 {'Authorization': 'Bearer token'}
    params    字典 {key:value,key:value}                      URL查询参数,会自动拼接成  ?key=value
    data      字典、元组,列表、字符串                            用于表单或普通文本
    json      字典、列表 {key:value}                           自动序列化为JSON,并设置Content-Type: application/json
    files     字典(值=文件对象/元组){file:f}    open ("filename") as  f                 
     用于上传文
    (multipart/form-data)

    一个示例

    image-20260527211609972

    每个api接口文档

    满足api接口文档要求就可以访问

    image-20260527211815979

    API接口文档:开发者与服务的’沟通桥梁’,包含了构建和发送请求报文所需的一切信息

    1. 接口与地址:明确API功能和URL
    2. 请求方法:指定接口操作类型,如GET(获取)、POST(创建)等
    3. 认证方式:详细如何进行身份验证(例如,在请求头中加入Authorization : Bearer Token(你创建的api—key)
    4. 请求参数:提供详细的请求参数列表,包括名称、类型、是否必填等
    5. 请求与响应示例:提供完整、可直接参考的示例,直观展示请求和返回的数据格式
    6. 错误代码:列出不同错误及处理方法,方便快速排查

    阅读文档的过程,就是帮助开发者系统化的构建出符合服务端要求的”请求报文”

    Deepseek 大模型理解

    根据接口文档的必要要求才可成功访问,所以本质是:==前端按照HTTP协议要求==成功发送请求报文到后端服务器,服务器根据已有的数据库的知识内容返回相应的响应体,这样就形成了人机交互

    1. 构建请求体:第一步对话的消息列表messages:教你设定模型的身份、角色、行为规则、回答风格,例如:”你是一个幽默的AI助手”

    role:值固定为system,表示这条消息是”系统级的指令”,不是用户或助手发的普通消息,可以在system消息里的content里,自己设定符合你需求的角色(做一个智能助手、只坐翻译,只写代码,或者扮演某个角色)

    1. "content":input("请输入你的请求:    "),
       "role": "user"     

    这是消息的用户指令,在运行时输入你想知道的数据知识或指令,角色定位为用户

    1. model:指定使用的是Deepseek哪个模型来处理你的请求,thinking是思考模式:控制模型是否展示它的内部推理过程(像人一样”先想一想再回答”) ; enabled(开启),disabled(关闭)
    2. reasoning_effort:控制模型在生成回答前进行”推理”的深度或强度,high是深度推理和运算;max_tokens取值一般为4096:模型生成的最大token数量(包括思考过程和最终长度),限制输出长度
    3. response_format:取值 type : text 指定模型返回结果的格式类型{ ‘text’ : 普通文本(默认). 模型输出纯文字,"json_object": 强制模型输出合法的JSON对象},方便开发者直接解析结构化数据.你的场景只需普通文本,所以设为’text’.
    4. stop : 指定一个或多个停止词[ ‘ nn ‘ ,’ 用户: ‘ ] 可防止模型继续生成对话,设置的 None 表示没有停止词,模型会一直生成直到max_tokens 限制或自然结束
    5. stream 取值 , False,作用:是否启用 ==流式输出==.
    • False:模型一次性返回完整回答(等待全部生成后响应)
    • True:模型以逐次/逐块返回,适合实时显示打字机效果
    1. stream_options 取 None 作用:当 stream=True 时的额外选项,具体可设置作用(用到再说,可返回token使用统计). 你的设置 : None , 因为未启用流式 ,所以该选项无用

    2. temperature : 取值为 1(范围通常 0~2,有时 0~1 ),作用:控制生成文本的随机性/创造性

    • 值越低(如0.1):结果越确定、保守,适合事实性问答
    • 值越高(如1.5):结果越多样、意外、适合创意写作
    • 1 的话是默认平衡值,随机性适中.
    1. top_p是核采样中的一个参数,用于控制大语言模型生成文本时的随机性和多样性.
    • 模型在生成下一个词时,会先列出所有可能词的概率
    • top_p:p=90%表示从概率最高开始累加,直到累加概率达到p为止,然后把那些累加达到概率要求的最高概率词,舍弃剩下的低概率词(10%),然后在这个新的词集中,按照概率词的权重来选
    1. tools :None或( 也可设为函数定义列表 ),作用:允许模型调用外部工具/函数(如查询数据库,调用API). 需要提供工具的描述和参数schema. 表示不启用工具调用
    2. tool_choice : 取值”None”( 其他值 :”auto”、或指定工具名如{“type”:”function”,”function”:{ “name” :”my_tool”}}

    作用:控制模型是否以及如何选择工具

    • “none”: 强制模型不使用任何工具
    • “auto”: 模型自行决定是否需要调度工具

    你的设置:”none”,彻底禁用工具调用

    1. logprobs :取值False,作用:是否返回输出token 的对数概率。
    • True:每个生成token的对数概率会被返回(可用于计算置信度)
    • 你的设置:False,不返回概率信息
    1. top_logprobs : None 不返回 top 概率词
    2. temperature和top_p都能控制生成文本的随机性/确定性,数值都调低时,两者都会让输出更稳定、更保守;temperature是整体调整概率分布的”曲线形状”,不会主动删掉低概率词,只是让他们更容易/更简单被抽到,top_p是动态地截断候选词表直接排除不符合的低概率词,然后对剩余词重新归一化.

    ==总结==:这些参数共同决定了模型的生成行为(随机性、停止条件、是否流式、是否输出概率,是否使用工具等).如果是标准的”普通对话”模式,无额外功能。

    请求头:字典里包含HTTP请求头字段,用于向服务器传递请求的元信息


    HTTP VS HTTPS

    HTTP:明文传输,任何人通过Wireshark这个物理层抓包软件可直接看到原始请求报文

    HTTPS=HTTP+TSL/SSL加密层:数据被加密成密文,只有客户端和服务器能用密钥解密,但是Reqable抓包软件可下载SSL根证书,所以可以根据SSL协议进行应用层抓包,会自动解析为明文

    GET:只读请求,用于获取数据,规范要求它不能修改服务器资源(幂等且安全)

    POST:提交数据,用于处理请求(比如创建,修改,删除),服务器根据你发送的Body数据做出相应的动作,并返回结果.

    所以==敏感数据要用POST+HTTPS==,并且放在Body里

  • Python网络编程2

    创建http服务器

    这是固定格式,通过HTTPServer创建服务,创建时给出ip地址、端口号和自定义处理类。

    在处理类中,http请求方法是通过do_[http_method]构成,例如do_Get,那所有的get请求都会被此函数处理,do_Post那么所有的post请求都会被此函数处理。

    ​ ● do_*函数调用的时机是,当客户端触发请求,服务端接受到后执行

    ​ ● do_*函数中处理的主要是,定义响应报文状态码,构造响应头,构造响应体,大部分情况下,end_headers()必须调用,且放置于send_response之后

    from http.server import BaseHTTPRequestHandler, HTTPServer
    
    class MyHandler(BaseHTTPRequestHandler):
        def do_GET(self):
            self.send_response(200)
            self.end_headers()
            self.wfile.write(b'{"msg":"Get"}')
    
        def do_POST(self):
            self.send_response(200)
            self.end_headers()
            self.wfile.write(b'{"msg":"Post"}')
    # 127.0.0.1:8080
    # localhost:8080
    # ip:8080
    server = HTTPServer(("0.0.0.0", 8080), MyHandler)
    server.serve_forever()

    image-20260601150528242

    ==总结==:服务端程序启动后不会自动退出,而是持续等待客户端的连接请求

    1. 绑定端口:服务端会在某个端口(比如8080)上开启服务,操作系统会为它保留这个通道

    2. 阻塞等待:会一直停在accept( )这个步骤,如果没有客户端连接,会陷入等待状态

    3. 唤醒处理:一旦有客户端发起请求,会唤醒服务端,处理完再次回到等待状态

    4. 永不退出:==会一直持续,除非手动停止服务==

    5. (”0.0.0.0″)和以上三个ip,==本质==:服务端监听时允许哪些客户端访问的区别. 0.0.0.0是一个特殊的通配地址:监听本机所有可用的网络接口

    6. 三个注释 IP 的含义

      · 127.0.0.1:本地回环地址。只有本机自己的程序能访问(比如用浏览器打开 http://127.0.0.1:8080),其他设备不行。 · localhost:域名,默认解析为 127.0.0.1(有时也会解析到 IPv6 的 ::1)。和 127.0.0.1 效果相同,只能本机访问。 · ip:8080:这里的“ip”通常指你机器的实际网络 IP(如局域网 IP 192.168.1.100,或公网 IP)。只有通过那个具体 IP 访问的客户端才能连上。

    7. 每请求一次都会生成一个日志:自己客户端的ip–请求日期,请求行,响应码

    http接口的定义(api)

    一般在后端发开中,会把 【请求方法+请求路径】 定义为一个http的接口,通过请求方法和请求路径的组合,来确定一个唯一的服务端处理逻辑。

    例如deepseek的接口文档中,查询余额和查询可用模型分别为

    ​ ● Get+/user/balance——意味着,后端服务实现的时候,对应了一个查询用户可用余额的逻辑

    ​ ● Get+/models——意味着,后端服务实现的时候,对应了一个返回模型列表的逻辑

    那如何用上述MyHandler做到这样的效果呢?

    字典的HTTP路由分发设计

    核心思想:将不同的URL路径对应的处理函数存储在一个字典(路由表)中,在请求处理时根据self.path查找并调用相应函数,实现请求的分发与响应的返回

    ==总结==:处理函数的参数(req):本质上是MyHandler的实例,通过该实例可以调用send_response、send_header、wfile.write,还有请求路径在路由表中,每个路径的响应逻辑独立封装在单独的函数中,易于新增路径:新增路径只需在GET_ROUTER字典中添加一个键值对,并实现对应的处理函数.

    from http.server import BaseHTTPRequestHandler, HTTPServer
    
    class MyHandler(BaseHTTPRequestHandler):
        def do_GET(self):
            print(self.path)
            if self.path == "/models":
                self.send_response(200)
                self.end_headers()
                self.wfile.write(b'{"msg":"models"}')
            elif self.path == "/user/balance":
                self.send_response(200)
                self.end_headers()
                self.wfile.write(b'{"msg":"balance"}')
            else:
                self.send_response(404)
                self.end_headers()
                self.wfile.write(b'{"msg":"Not Found"}')
    
        def do_POST(self):
            self.send_response(200)
            self.send_header("Content-type", "application/json")
            self.end_headers()
            self.wfile.write(b'{"msg":"Post"}')
    
    
    server = HTTPServer(("0.0.0.0", 8080), MyHandler)
    server.serve_forever()
    

    在原有的基础上,你可以传递handler对象

    from http.server import BaseHTTPRequestHandler, HTTPServer
    
    
    def reshandle(httpObj):
        httpObj.send_response(200)
        httpObj.send_header("Content-type", "application/json")
        httpObj.end_headers()
        httpObj.wfile.write(b'{"msg":"okk"}')
    
    
    class MyHandler(BaseHTTPRequestHandler):
        def do_GET(self):
            print(self.path)
            reshandle(self)
    
        def do_POST(self):
            self.send_response(200)
            self.send_header("Content-type", "application/json")
            self.end_headers()
            self.wfile.write(b'{"msg":"Post"}')
    
    
    server = HTTPServer(("0.0.0.0", 8080), MyHandler)
    server.serve_forever()
    

    ==总结==:通过URL和请求方法可以区分出后端的处理函数,所以一个接口真正的区分来自于后端处理函数的区分

    客户端ip+端口号可变,但是服务端ip+端口号不可变

    如何获取http请求参数

    获取查询参数

    从self.path中解析

    from http.server import BaseHTTPRequestHandler, HTTPServer
    from urllib.parse import parse_qs, urlparse
    
    class MyHandler(BaseHTTPRequestHandler):
        def do_POST(self):
            print(self.path)
            parsed_path = urlparse(self.path)
            # 解析查询参数
            query_params = parse_qs(parsed_path.query)
            print(query_params)
            self.send_response(200)
            self.send_header("Content-type", "application/json")
            self.end_headers()
            self.wfile.write(b'{"msg":"Post"}')
    
    
    server = HTTPServer(("0.0.0.0", 8080), MyHandler)
    server.serve_forever()
    

    扩展(URL查询参数a={ }怎么编码到查询参数里)

    原因:URL查询参数对字符的”容忍度”非常低,而且不同环境的标准还不统一,如果不编码,你传的东西很可能会被误解甚至弄丢。

    ==方法==:

    • 序列化:(对象—–>字符串),把字典/对象转成JSON字符串
    import json
    data = {"name": "张三", "age": 20}
    json_str = json.dumps(data)  # 结果:'{"name": "张三", "age": 20}'
    • URL编码(字符串——>==百分号编码==(URL编码))

    用 quote( ) 把 JSON 字符串里的特殊字符全部转成%XX形式

    from urllib.parse import quote
    encoded_value = quote(json_str)  # 结果:'%7B%22name%22%3A%20%22%E5%BC%A0%E4%B8%89%22%2C%20%22age%22%3A%2020%7D'
    • 拼接到URL
    url = f"https://example.com/api?a={encoded_value}"
    # 完整结果:https://example.com/api?a=%7B%22name%22%3A%20%22%E5%BC%A0%E4%B8%89%22%2C%20%22age%22%3A%2020%7D
    • 服务端解码(还原)
    from urllib.parse import unquote
    import json
    
    decoded_str = unquote(encoded_value)        # 还原JSON字符串
    original_dict = json.loads(decoded_str)     # 还原字典对象
    不要做的事 正确做法
    直接拼接 ?a={‘name’:’张三’} 先转JSON再编码
    只编码不序列化 先序列化成字符串再编码
    编码整个URL 只编码参数值
    …………………………… 用标准库 quote()

    获取请求头和请求体

    from http.server import BaseHTTPRequestHandler, HTTPServer
    
    
    def reshandle(httpObj):
        httpObj.send_response(200)
        httpObj.send_header("Content-type", "application/json")
        httpObj.end_headers()
        httpObj.wfile.write(b'{"msg":"okk"}')
    
    
    class MyHandler(BaseHTTPRequestHandler):
        def do_GET(self):
            print("-------")
            # 获取所有的请求头部字段
            print(self.headers)
            print(self.headers.get("Content-Length", 0))
            length = int(self.headers.get("Content-Length", 0))
            print("-------")
            # 获取请求体,注意,read必须指定长度,否则会一直阻塞
            # 至于请求体怎么解析,需要和客户端协商好,比如是json字符串,那就可以通过json转成字典
            # 如果是文件,那可以配合文件api完成文件写入
            print(self.rfile.read(length))
            print("-------")
            reshandle(self)
    
        def do_POST(self):
            self.send_response(200)
            self.send_header("Content-type", "application/json")
            self.end_headers()
            self.wfile.write(b'{"msg":"Post"}')
    
    
    server = HTTPServer(("0.0.0.0", 8080), MyHandler)
    server.serve_forever()


    转存文件示例

    这里文件直接以二进制字节流传输

    from http.server import BaseHTTPRequestHandler, HTTPServer
    
    
    def reshandle(httpObj):
        httpObj.send_response(200)
        httpObj.send_header("Content-type", "application/json")
        httpObj.end_headers()
        httpObj.wfile.write(b'{"msg":"okk"}')
    
    
    class MyHandler(BaseHTTPRequestHandler):
        def do_GET(self):
            print("-------")
            length = int(self.headers.get("Content-Length", 0))
            fileBytes = self.rfile.read(length)
            with open("test.txt", "wb") as f:
                f.write(fileBytes)
            print(fileBytes)
            print("-------")
            reshandle(self)
    
        def do_POST(self):
            self.send_response(200)
            self.send_header("Content-type", "application/json")
            self.end_headers()
            self.wfile.write(b'{"msg":"Post"}')
    
    
    server = HTTPServer(("0.0.0.0", 8080), MyHandler)
    server.serve_forever()
    

    如何返回请求数据

    控制响应头

    send_header(key, value)

    返回json

    self.wfile.write(
        json.dumps({"success": True, "data": {"name": "张三"}}).encode()
    )

    返回文件

    图解HTTP.pdf

    返回图片,pdf,附件等形式

    content-type,类型非常多,但一般常见的就是image、pdf、json、plain等,下图中是常见的

    image-20260603154157092

    以附件形式返回,强制下载

    from http.server import BaseHTTPRequestHandler, HTTPServer
    from urllib.parse import quote
    
    
    class MyHandler(BaseHTTPRequestHandler):
        def do_GET(self):
            with open("图解HTTP.pdf", "rb") as f:
                data = f.read()
                self.send_response(200)
                self.send_header(
                    "Content-Disposition",  # 可以强行以附件形式下载,静止客户端渲染
                    f"attachment; filename={quote('图解HTTP.pdf')}",
                )
                self.end_headers()
                self.wfile.write(data)
    
    
    server = HTTPServer(("0.0.0.0", 8080), MyHandler)
    server.serve_forever()

    flask框架

    第一个http服务器

    from flask import Flask     # 导入Flask类
    
    app = Flask(__name__)      #创建Flask应用实例,__name__表示当前模块名
    
    # 匹配http url
    @app.route("/user",methods=["GET"])     # url和请求方法用装饰器就搞定了,相当于路由分发,根据装饰器后面的路径参数,和请求方法来触发服务端处理函数
    def hello_world():                      # 处理函数通过上面的装饰器触发
        return "<p>Hello, World!</p>"  
    
    # 启动服务器,监听所有ip地址的3000端口
    app.run(host="0.0.0.0", port=3000)

    ==总结==:

    • @装饰器(’/user’,methods=[“GET”])匹配服务端接口,客户按照接口要求构造请求才可得到响应

    • def hello_world( )是服务端处理函数,构造响应体

    整体参数收集和响应

    from flask import Flask, request
    
    app = Flask(__name__)
    
    @app.route("/models/<model_id>", methods=["GET"])
    def hello_world(model_id):  # 路径参数
        print(request.args)  # 查询参数
        print(request.headers)  # 请求头
        # 获取 JSON 请求体
        bodyJson = request.get_json()
        print(bodyJson)
        # 获取表单数据(application/x-www-form-urlencoded,multipart/form-data普通字段)
        bodyFormData = request.form
        print(bodyFormData)
        # 获取原始请求体
        bodyRaw = request.get_data()
        print(bodyRaw)
        # 获取文件数据(multipart/form-data)
        bodyFiles = request.files
        print(bodyFiles)
        # 第一个参数响应体,第二个参数状态码,第三个参数响应头
        return {"success": True, "model_id": model_id}, 400, {"cusHeader": "aaaaa"}
    
    app.run()

    返回文件

    from flask import Flask, send_file
    
    app = Flask(__name__)
    
    @app.route("/download/file")
    def download_image():
        # 下载图片并在浏览器显示,文件是流式传输的
        return send_file(
            "图解HTTP.pdf",  # 不需要我们转url编码
            mimetype="application/pdf",
            as_attachment=True,  # 浏览器内显示而不是下载
        )
    
    app.run()

    文件的流式处理

    无论是客户端还是服务端,凡是设计到文件读写,都需要考虑能不能一次性把文件全部加载到内存,之后再处理。一般小文件可以直接全部加载至内存,但是对于几个g的大文件,我们没法这样处理,会导致内存溢出oom,所以,在客户端通过http传递大文件,要采用分块传输,在服务端通过http传递大文件时,同样需要分块传输。

    而客户端传输分块动作,requests帮我们做了,只需要指定文件对象,它自动分块传输;同样,服务端的分块动作,send_file函数照样帮我们做了;但是==客户端如何接收流式的文件以及服务端如何接收流式的文件,均需要自行处理==

    ​ 1. 客户端接收

    import requests
    
    def receive_stream_to_file():
        url = 'http://example.com/stream'
        response = requests.get(url, stream=True)
    
        # 以二进制写入模式打开文件
        with open('output.txt', 'wb') as f:
            for chunk in response.iter_content(chunk_size=1024):
                if chunk:
                    f.write(chunk)  # 直接写入文件    
        print("文件保存完成")
    
    # 使用
    receive_stream_to_file()

    ​ 2. 服务端接收

    from flask import Flask, request, jsonify
    import os
    
    app = Flask(__name__)
    
    @app.route('/stream', methods=['POST'])
    def test_stream():
        """流式接收并写入文件"""
        filename = 'uploaded_file.bin'
        chunk_count = 0
        total_bytes = 0
    
        # 边接收边写入文件
        with open(filename, 'wb') as f:
            for chunk in request.stream:
                if chunk:
                    f.write(chunk)
                    chunk_count += 1
                    total_bytes += len(chunk)
    
        return jsonify({
            "method": "stream", 
            "chunks": chunk_count, 
            "size": total_bytes,
            "saved_to": filename
        })

    ==原理==:

    1. chunk(bytes字节串)是编程中的通用术语,意为”数据块”或”片断”,在流式传输的代码中,chunk特指:从一个完整的数据流中,切分出来的一小段二进制数据

    2. 避免一次加载整个文件到内存

    3. stream=True ,让requests从”先全部下载再处理”变成”边下载边处理”

    4. 适用于大文件传输(防止内存爆掉)


    ==总结==:

    常见接收类型

    1. form_data中非文件类型的字段(正常的普通键值对)和urlencode里的普通字段就用==request.form==接收 ; form_data还可以传

    (一般放在字段value里),那就用==request.files==接收

    1. 报文改变请求体中数据编码的格式,而你==后端用不同的函数接收,就是后端的框架自动将客户端发过来的请求报文中请求体的内容做了对应的转换,从而让我们站在服务端的角度非常容易拿到客户端数据,flask框架写接口太简单了,前端无论怎么传数据传文件,要想转存数据直接用save( )==

    2. 传json直接get_json(),传的是form_data就用form, form_data里放文件就用file接收

    3. 如果用urlencode就用form接受,如果是查询参数直接用args接收

    4. 路径参数就用==标识符==,用变量的方式接收

    5. 这些都是拿客户端数据


    flask框架控制响应码,响应头,响应体 ;浏览器是客户端带渲染

    1. send_file配合as_attachment=True就可以让客户端访问浏览器下载文件了

    后端接口(API)和数据库

    如何通过后端接口(API)从 数据库中获取数据,并返回给客户端. Flask + SQL

    一、整体流程

    1. 客户端 → 发送 HTTP 请求(如 GET /api/users)
    2. 后端(Flask) → 接收请求,解析参数
    3. 后端 → 连接数据库,执行 SQL 查询
    4. 数据库 → 返回查询结果
    5. 后端 → 将数据转换为 JSON 格式
    6. 客户端 ← 收到 JSON 数据

    流程:

    后端接口——>数据库——>返回 JSON模式

    SDK和HTTP

    SDK(Software Development kit ,软件开发工具包)是对底层HTTP API 的封装。它把鉴权,请求构造,参数校验,序列化,错误重试等通用逻辑写在一个库里面,==对外暴露更符合开发习惯的函数或类方法==

    你==只需要关心业务参数(Bucket,文件路径)==,不需要自己构造签名,拼接URL,处理分块上传等复杂逻辑

    二.

    SDK VS 原生HTTP请求

    特性 直接 HTTP 请求 SDK
    鉴权 手动拼 Token / 签名 SDK 自动计算并添加
    参数校验 自己 if 判断 SDK 提前检查,报错更友好
    请求构造 拼接 URL、编码 body 调用函数,传入对象即可
    响应解析 response.json() 再取值 SDK 直接返回 Python 对象
    错误处理 判断状态码,解析错误码 SDK 抛出具体异常,信息明确
    重试/超时 自己写循环 SDK 内置可配置的重试策略
    版本兼容 API 升级后要改代码 SDK 升级后内部适配,调用方代码不变

    ==总结==:

    1. SDK = 让你像调用本地函数一样调用远程API,屏蔽了HTTP的细节

    2. SDK 是在 HTTP 之上的一层封装,它把“协议细节”变成了“函数调用”,让接口请求逻辑更聚焦于业务。

    ​ · 理解 HTTP 是基础(URL、方法、header、body、状态码)。 ​ · 使用 SDK 是提升效率的手段(省去机械重复的请求代码)。 ​ · 一个优秀的 SDK 会帮你处理:鉴权、参数校验、序列化、错误处理、重试、连接池、日志等所有非功能性需求

    ​ 如果你是 API 提供方,提供 SDK 可以极大降低接入成本;如果你是 API 调用方,优先找官方 SDK,没有的话再自己封装 HTTP。

    套壳deepseek

    from flask import Flask, send_file, request
    
    from openai import OpenAI
    
    
    app = Flask(__name__)
    client = OpenAI(api_key="sk-6429bd0a0d184d4dbe811055f95a8cf8", base_url="https://api.deepseek.com")
    
    # 匹配http url
    app.route("/download", methods=["GET"])
    def hello_world():
        # print(request.args['name'])
        # print(request.headers['Host'])
        return send_file("图解HTTP.pdf", as_attachment=True)
    
    @app.route("/ai/chat", methods=["GET"])
    def get_time():
        question = request.args['q']
        response = client.chat.completions.create(
        model="deepseek-v4-pro",
        messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": question},
        ],
        max_tokens=1024,
        temperature=0.7,
        stream=False,
        )
        print(response.choices[0].message.content)
        #deepseek请求放到这里,SDK
        return {"success": True, "answer": response.choices[0].message.content}
    
    app.run(host="0.0.0.0", port=8080)

    浏览器返回的响应体

    image-20260603095529456

    ==原因==:

    flask 框架在 return { },以字典构造json字符串时,flask会自动帮你把字典(python对象)序列化为json字符串,但是默认会有ensure_ascii=True,但是所有数据(中文字符,英文字符)存储数据都是以二进制字节形式存储,所以返回的其实是这个,但是要转为ascii,二进制字节超过了ascii的码表范围,所以转为了unicode转义序列,转义序列可以全部转为ascii,如果不想要转义序列,就直接去掉默认的ensure_ascii=True,在创建应用实例后面ensure_ascii=Flase,就可以返回二进制响应体然后经浏览器自动解析为中文字符

    任务

    1. 使用requests库,调用deepseek,完成一轮ai对话

    2. 在flask项目下创建一个文件夹,里面放一些文件,通过/files获取到所有文件的下载路径

    ​ a. 浏览器访问下载路径,可以下载文件

    1. 理解网站静态资源的本质,使用2中的程序,完成网站资源部署

    flask托管静态文件

    from pathlib import Path
    
    from flask import Flask
    
    staticPath = Path(__file__).parent / "static"
    print(staticPath)
    
    # /static url路径
    app = Flask(__name__, static_url_path="/static", static_folder=staticPath)
    
    app.run(host="0.0.0.0", port=3000)

    实现静态文件托管

    from pathlib import Path
    
    from flask import Flask, send_file
    
    app = Flask(__name__)
    
    # 路径参数
    @app.route("/static/<file>")
    def hello_world(file):
        filePath = Path(__file__).parent / "static" / file
        if not filePath.exists():
            return "<p>File not found</p>", 404
        return send_file(filePath)
    
    
    app.run(host="0.0.0.0", port=3000)
    

    image-20260603153905017

    实现文件列表

    from pathlib import Path
    
    from flask import Flask, send_file
    
    app = Flask(__name__)
    
    
    @app.route("/static/<file>")
    def hello_world(file):
        filePath = Path(__file__).parent / "static" / file
        if not filePath.exists():
            return "<p>File not found</p>", 404
        return send_file(filePath)
    
    
    @app.route("/static")
    def getFileList():
        filePath = Path(__file__).parent / "static"
        files = [f.name for f in filePath.iterdir() if f.is_file()]
        print(files)
        [f"<a href='/static/{i}'>{i}</a>" for i in files]
        return "<br/>".join([f"<a href='/static/{i}'>{i}</a>" for i in files])
    
    
    app.run(host="0.0.0.0", port=3000)

    文件托管和下载原理

    本质是两个处理函数:第一个触发每个文件的请求路径,第二个是可以点击触发第二个处理函数来下载文件

    第二个服务端处理函数

    image-20260603162723364

    image-20260603165114505

    image-20260603165155942

    部署静态网站

    website.zip

    from pathlib import Path
    
    from flask import Flask, send_file
    
    app = Flask(__name__)
    
    
    @app.route("/")
    def index():
        indexPath = Path(__file__).parent / "static" / "website" / "index.html"
        return send_file(indexPath)
    
    
    @app.route("/images/<file>")
    def getImgList(file):
        filePath = Path(__file__).parent / "static" / "website" / "images" / file
        if not filePath.exists():
            return "<p>File not found</p>", 404
        return send_file(filePath)
    
    
    @app.route("/scripts/<file>")
    def getScript(file):
        filePath = Path(__file__).parent / "static" / "website" / "scripts" / file
        if not filePath.exists():
            return "<p>File not found</p>", 404
        return send_file(filePath)
    
    
    @app.route("/css/<file>")
    def getCSS(file):
        filePath = Path(__file__).parent / "static" / "website" / "css" / file
        if not filePath.exists():
            return "<p>File not found</p>", 404
        return send_file(filePath)
    
    
    app.run(host="0.0.0.0", port=3000)

    ==使用flask内置功能==

    from flask import Flask
    
    app = Flask(__name__, static_folder="static/website", static_url_path="/")
    
    
    app.run(host="0.0.0.0", port=3000)

    实现:

    image-20260603220757176

    正常访问

    ==总结==:

    1. 手动搭建一个静态文件服务器来托管前端网站
    • 浏览器渲染机制

    首次访问返回index.html后,浏览器解析HTML时会自动发起新的HTTP请求,去获取页面中引用的图片,CSS,JS,音视频等静态资源

    • 这些二次请求必须能正确返回对应文件,否则页面显示不全(出现404)
    1. 托管文件
    • 将所有前端文件(HTML,CSS,JS,图片等)统一放在一个目录下,例如 website/
    • 在服务端配置==静态文件中间件==,将该目录声明为根路径 / 的静态资源目录
    • 访问根路径 / 时返回 index.html ; 访问其他路径(如/ style.css 、/ image.png)时,直接在目录中查找对应文件并返回
    1. 实现要点
    • 不需要为每个文件单独写路由,==只需要一个通配处理==:将请求的URL的路径部分作为相对于 website/ 的路径,读取文件并返回
    • 这样就能实现:一次入口请求 + 浏览器自动二次请求所有依赖资源,从而完整渲染整个网站
    1. 本质目标:

    独立用代码实现一个静态文件服务器(类似 serve 、http-server 的功能),把前端项目完整托管起来,达到”输入根路径即可访问整个网站”的效果

    复现

    image-20260603201656959


    浏览器显示


    打开前端浏览器看看网络,刷新下看看哪些没拿到

    image-20260603202600255


    需要的请求路径

    image-20260603202953638

    怎样修复

    因为没拿到相应的请求路径,所以有的没显示出来,所以==为了恢复应拿到的,应该把文件路径全部托管起来==

    1. 修复图片:请求/image的/<image_name>的图片能找到这个文件,并把这个文件返回给你,解决404问题

    image-20260603204732714

    恢复了图片

    image-20260603205213689


    1. 恢复css数据

    定义一个css接口

    image-20260603205523723

    恢复了css

    image-20260603205723679


    1. 恢复scripts

    image-20260603210249951

    恢复后的scripts

    image-20260603210415267

    原理

    • 都是先请求静态资源文件,然后由浏览器解析它,代码是web开发工程师写出来的

    ​ 这就是部署一个前端网站

    • 浏览器中只要把index_html给它,浏览器解析这个时,会自动加载非常多的东西,你只需要把对应文件全部托管好,就可以了

    ==总结==:

    原理:

    1. 装饰器参数
    • 装饰器参数 是指写在装饰器(如 @app.route( ))括号内的配置项,用于告诉 Web 框架(如 Flask)这个被装饰的函数应该匹配什么样的 HTTP 请求规则。

      常见的装饰器参数包括:

      · URL 路径模式(如 ‘/files/<file_name>’) · 请求方法(如 methods=[‘GET’, ‘POST’])

      核心作用:声明式配置,将“如何匹配请求”的元数据附加在函数上,而不需要修改函数内部代码

    1. 客户端标识符
    • 客户端标识符 是指客户端(如浏览器、移动应用、API 调用者)在发起 HTTP 请求时,在 URL 路径中实际填入的动态值。

      例如:

      · 装饰器中定义的路由模板是 /users/<user_id> · 客户端请求的 URL 是 /users/12345 · 那么 12345 就是客户端标识符

      核心作用:作为真实数据,标识具体要操作的资源(如某个用户、某篇文章、某个文件)

    1. ==动态路由映射==

    ​ 动态路由映射 是 Flask 框架提供的一种机制: ​ 将 URL 路径中可变的部分(通过装饰器参数中的 <变量名> 标记)自动提取出来,并作为同名参数传递给被装饰的函数。

    ​ 简单说:把 URL 里的动态值“映射”成函数的参数

    1. 三者从动态路由映射角度的关系

    ​ 在动态路由映射中的角色 ​ 装饰器参数 定义“映射的规则”——告诉 Flask 哪个位置是动态的,变量名叫什么 ​ 客户端标识符 提供“映射的源数据”——URL 中实际出现的具体值 ​ 动态路由映射 执行“映射的动作”——把客户端标识符的值提取出来,填进装饰器参数定义的变量名里,然后传给函数

    重定向

    本质:是一种“资源寻址转交”机制:服务端不直接返回请求的资源,而是返回资源的“新地址”,由客户端再次发起请求,两次发起请求

    1. 访问 http://IP:端口(没有额外路径)时,一般不使用重定向机制。 它请求的就是根路径 /,服务器直接返回对应的资源(比如 index.html),整个过程是一次请求、一次响应。

    2. 在 URL 路径中,/ 表示根路径。 你定义接口为 /,就是让服务器处理对根路径的请求。

      当你访问 http://IP:端口(浏览器地址栏只输入 IP 和端口,没有 /),浏览器自动补全为 http://IP:端口/,因为斜杠是路径的起始符号。 所以最终到达服务器的请求就是 GET /。

      此时服务器直接返回文件(如 HTML),不需要重定向,状态码是 200 OK。

    3. 什么时候会用到重定向?

      在静态服务器中,重定向通常出现在访问 没有尾随斜杠的目录路径 时。例如:

      · 你的文件目录里有一个 images/ 文件夹 · 用户请求 http://IP:端口/images(没有最后的 /)

      很多静态服务器(如 Nginx、Express 的 serve-static)会返回 301 或 302,重定向到 http://IP:端口/images/ .

    4. “访问 IP+端口没有出现后面斜杠,就是用重定向机制” —— 不是的。根路径本身不需要重定向。重定向主要用于 目录路径缺少尾随斜杠 的场景,目的是保证 URL 语义和资源定位的正确性

    ==总结==:只有请求路径为目录(文件夹)并且后面没有 / 时,才会触发重定向q

    socket

    # server.py 代码
    import socket
    
    server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    
    server.bind(("127.0.0.1", 8080))
    
    server.listen(5)
    
    while True:
    
        conn, client_addr = server.accept()
        print(conn, client_addr, sep="n")
    
        from_client_data = conn.recv(1024)
        print(from_client_data.decode("utf-8"))
    
        conn.send(from_client_data.upper())
    
        conn.close()
    

    粘包问题

    tcp的buffer是每个socket描述符一个,所以多客户端之间的数据互不干扰。而粘包需要解决的是,同一个客户端消息边界怎么区分

    img

    设计一个协议,区分消息边界,比如

    大端和小端

    大端是指:字节高位放在低地址

    小端是指:字节地位放在低地址

    img

    python中对字节操作

    import struct
    
    # < 小端字节序
    # > 大端字节序
    # 一般把字节从左到右当作内存从低地址到高地址
    data = struct.pack("> i", 0x1234)
    print(data.hex())
    
    val = struct.unpack("> i", data)[0]
    print(hex(val))

    协议设计

    TP协议
    +-----------------+--------------------------+
    |  4 bytes (LE)   |      N bytes (文本)       |
    |  内容长度(N)     |       实际内容             |
    +-----------------+--------------------------+

    示例

    import json
    import struct
    
    
    def encode(msg):
        data = msg.encode("utf-8")
        return struct.pack("<I", len(data)) + data
    
    
    def decode(data):
        length = struct.unpack("<I", data[:4])[0]
        return data[4 : 4 + length].decode("utf-8")
    
    
    buf = encode(json.dumps({"name": "张三"}, ensure_ascii=False))
    print(buf.hex())
    print(decode(buf))
    

    可以在此网站配置尝试看看编码结果是否正确字符 编码/解码 – 锤子在线工具

    课件中解析实例大家自己练习了

    挑战:先使用flask托管static文件,写一个接口,通过此接口上传文件,并返回文件的下载地址

    post /upload/file 请求体中放文件

    response: {“success”:true,downloadUrl:””}

    静态文件服务器

    定义 静态文件服务器是一种专门用于提供==不会动态变化== 的文件的服务器。

    核心特点

    · 文件内容固定,无论谁访问、何时访问,返回都一样 · 不涉及数据库查询、用户登录、实时计算等后端逻辑 · 服务器只做一件事:==根据 URL 路径找到对应的文件,读出来,返回给客户端==

    总结 把硬盘上的文件通过 HTTP 协议共享出去,让浏览器能直接访问 —— 这就是静态文件服务器。

    Nginx和Apache之后会学到

    HTML(超文本标记语言)

    HTML(超文本标记语言,HyperText Markup Language) 是一种用于描述网页结构和内容的标记语言。它使用成对的标签(如 <h1>、<p>)来标注文本、图片、链接等元素,==浏览器按标准解析这些标签并渲染成可视化网页。==

    核心作用

    1. 搭建网页结构

    定义标题、段落、列表、表格、表单、图片、视频等内容的布局与层次.

    1. 承载超文本与多媒体

    通过超链接(<a>)实现页面跳转;嵌入图片、音频、视频等非文本资源。

    1. 跨平台展示

    同一份 HTML 文件可在不同操作系统(Windows、macOS、Linux、手机)的浏览器中正常显示。

    1. 作为前端基础

    与 CSS(样式)、JavaScript(交互)协作,构成完整网页或应用。HTML 只负责结构,样式与行为由 CSS/JS 处理。

    总结:

    HTML 是所有网页的骨架,它用标签定义内容含义,浏览器自动渲染成可见界面。

    Web

    Web 是一个通过 HTTP 协议访问、使用 URL 定位资源、以超链接互联的分布式信息系统。

    核心要素: · HTTP/HTTPS 协议:统一的数据传输规则。 · URL(统一资源定位符):每个资源的唯一地址。 · HTML:页面结构和内容的描述语言。 · 超链接:资源之间相互关联的纽带。 · 本质:Web 是运行在互联网之上的信息空间,通过浏览器访问网页、在线应用、视频等资源。

    二、前端与后端的定义

    · 前端:用户直接交互的部分,运行在浏览器中。负责页面展示、接收用户操作、发送请求并更新界面。核心技术:HTML、CSS、JavaScript。 · 后端:运行在服务器上的程序,用户不可见。负责处理业务逻辑、数据存取、安全验证、返回响应。常见技术:Java、Python、Node.js、Go 等,配合数据库

    三、前端与后端相互联系的过程(完整链路)

    整个过程遵循 HTTP 协议

    1. 用户触发 → 前端监听用户动作(点击、输入等)。
    2. 前端构建请求 → 向后端的特定 URL(API 地址)发送 HTTP 请求,包含: · 请求方法(GET、POST 等) · 请求头(如身份令牌 Token、Content-Type) · 请求体(如 JSON 格式的用户数据)
    3. 网络传输 → 请求经互联网送达后端服务器。
    4. 后端处理 → · 解析请求,验证身份和参数。 · 调用业务逻辑(如计算、查询数据库)。 · 生成响应数据(通常为 JSON 或 HTML)。
    5. 后端返回响应 → 发送 HTTP 响应,包含: · 状态码(200 成功、404 未找到等) · 响应头 · 响应体(数据或错误信息)
    6. 前端接收并更新界面 → · 解析响应数据。 · 根据结果动态修改 DOM(如显示内容、跳转页面或弹出错误提示)。

    关键点总结:

    · 前后端通过 API 文档 约定接口格式。 · 现代 Web 采用 前后端分离:后端只提供数据接口,前端独立渲染。

    一句话描述联系过程:

    前端向后端发送 HTTP 请求,后端处理请求并返回数据,前端根据返回的数据更新用户界面。

  • 面试题

    一、三次握手的具体过程

    TCP 是面向连接的可靠传输协议,通信前需通过“三次握手”建立连接。以客户端主动连接服务器为例:

    image-20260608123555082

    二、为什么需要第三次握手?—— 核心原因

    第三次握手是为了防止已过期的连接请求报文突然又传到服务器,导致服务器错误地建立一个无效连接,从而浪费资源。

    image-20260608123828237


    粘包问题

    ==原因==:

    发送方、接收方 和 两个维度分解。

    1. 发送方原因:TCP 协议栈的优化行为

    • Nagle算法(默认开启): 为了减少小包数量,TCP 会等待一小段时间(通常 200ms),如果发送缓冲区中有多个小消息,或者等待期间收到了之前消息的 ACK,就会将多个小消息合并成一个 TCP 段发出。 → 导致:多个应用层消息粘在一起(粘包)。
    • 最大分段大小(MSS)限制: TCP 段的数据部分不能超过 MSS(通常由路径MTU 决定,典型值 1460 字节)。如果一个应用层消息大于 MSS,TCP 会将其拆分成多个段。 → 导致:一个消息被分成多次发送(拆包)。
    • 发送缓冲区策略: 应用程序 write 的数据先复制到内核发送缓冲区。TCP 会按照自身的拥塞控制和流量控制来决定何时真正发送、发送多少。即使你分两次 write,也可能被一次性发出。

    2. 接收方原因:应用程序读取不及时

    • 接收缓冲区堆积: 内核将收到的 TCP 段存入接收缓冲区。如果应用程序调用 recv 不够快,多个消息就会堆积在缓冲区中。当应用程序最终调用 recv 读取一个大块时,可能一下子取走多个消息。 → 导致:粘包。
    • 用户缓冲区长度限制: 调用 recv(buf, len) 时,若 len 小于消息的实际长度,则只能读出部分数据,剩余数据留在缓冲区中。下次再读时,可能读到某个消息的后半部分,或者读到下一个消息的前半部分。 → 导致:拆包(也叫半包)。

    ==本质==

    TCP 是面向字节流的协议,它只保证字节序列的有序、可靠传输,但不维护、不识别应用层消息之间的边界。 因此,多个应用层消息在字节流中可能“粘”在一起,也可能一个消息被拆成多个片段,“粘包”和“拆包”是同一本质的两种表现形式。

    解决方案

    一.直接使用已封装好消息边界的库/协议

    不直接操作裸 Socket,而是==选用已经内置了粘包处理能力==的:

    image-20260608100253598

    二、为什么使用(原因)

    • TCP 粘包是必然且无法避免的 只要使用裸 TCP Socket,就必须手动处理粘包/拆包,否则程序必然出错。

    • 手动处理粘包具有较高复杂度 需要考虑:缓冲区管理、长度字段解析、跨包拼接、大消息分块、性能优化、错误恢复、恶意报文防护等。这些细节很容易写出 bug。

    • 成熟的库/协议已经解决了所有边界情况 经过全球海量生产环境验证,覆盖了各种网络异常、性能场景,不需要重复造轮子。

    • 团队协作与可维护性 统一使用标准协议(如 HTTP/gRPC),任何语言的客户端都能互通,且代码可读性高;而私有协议需要文档、对齐、调试,维护成本高。

    三.优点(使用带来的好处)

    image-20260608100431720

    ==总结==:使用现成库/协议解决粘包,就是用“行业标准方案”替代“手写轮子”,换来高效率、高可靠、低维护成本的工程收益。在实际项目中,除非有极轻量的私有协议需求,否则这永远是首选做法。


    TCP四次挥手过程,分别有哪些定时器,都是干什么的

    image-20260608125132405

    image-20260608125238244


    TCP四次挥手什么情况会出现time_wait,怎么排查是什么问题

    image-20260608131749620

    image-20260608131935319

    如何排查

    排查 TIME_WAIT 问题,关键在于要区分 “这是否已经造成了实际故障” 。少量 TIME_WAIT 是 TCP 协议的正常行为,只有当数量过多导致资源耗尽时,才需要介入。

    我把整个排查思路整理成了一个流程,你可以参考:

    image-20260608132707724

    具体内容详细问deepseek

  • 小黑算法

    • 什么是算法

    在计算机领域里,==算法是一系列程序指令==,用于处理特定的运算和逻辑 问题。 衡量算法优劣的主要标准是时间复杂度和空间复杂度。

    • 什么是数据结构

    数据结构是数据的组织、管理和存储格式,其使用目的是为了高效地访 问和修改数据。 数据结构包含数组、链表这样的线性数据结构,也包含树、图这样的复 杂数据结构。

    • 什么是时间复杂度

    时间复杂度是对一个算法运行时间长短的量度,用大O表示,记作 T(n)=O(f(n))。 常见的时间复杂度按照从低到高的顺序,包括O(1)、O(logn)、O(n)、 O(nlogn)、O(n 2 )等。

    • 什么是空间复杂度

    空间复杂度是对一个算法在运行过程中临时占用存储空间大小的量度, 用大O表示,记作S(n)=O(f(n))。 常见的空间复杂度按照从低到高的顺序,包括O(1)、O(n)、O(n 2 )等。 其中递归算法的空间复杂度和递归深度成正比.

    小结 什么是数组 数组是由有限个相同类型的变量所组成的有序集合,它的物理存储方式 是顺序存储,访问方式是随机访问。利用下标查找数组元素的时间复杂 度是O(1),中间插入、删除数组元素的时间复杂度是O(n)。 什么是链表 链表是一种链式数据结构,由若干节点组成,每个节点包含指向下一节 点的指针。链表的物理存储方式是随机存储,访问方式是顺序访问。查 找链表节点的时间复杂度是O(n),中间插入、删除节点的时间复杂度是 O(1)。 什么是栈 栈是一种线性逻辑结构,可以用数组实现,也可以用链表实现。栈包含 入栈和出栈操作,遵循先入后出的原则(FILO)。 什么是队列 队列也是一种线性逻辑结构,可以用数组实现,也可以用链表实现。队 列包含入队和出队操作,遵循先入先出的原则(FIFO)。