函数是一段组织好的、==可重复使用==的代码,用于==执行特定的任务==。函数==接受参数==,并可以返回输出。函数可以帮助我们组织代码,提高可读性和重用性。
Python函数编程
函数定义
函数定义用 def 关键字,后面跟函数名和参数列表,函数体由缩进的代码块组成。
语法:
def function_name(参数):
    """函数的文档字符串,来描述函数做什么的"""
    # 函数体
    # 执行任务的代码
函数调用
调用函数时,要使用函数名,并==传入参数==。
函数返回值
函数用 return 语句得到返回值,没有 return,函数默认返回 None。
return 关键字的作用:
return后面的值叫“返回值”- 没
return的情况下,会默认返回一个 None - 一旦遇到 return,结束整个函数
- 返回多个值会被组织成元组返回,也可以用多个值来接收
- 使用多个值接收(值的数量必须跟返回值数量对应)
示例:
# 1. 无返回值的函数(默认返回None)
def greet():
    print("Hello!")

result = greet()
print(f"函数无返回值return: {result}")  # 输出: None

# 2. 单返回值的函数
def calculate_square(number):
    return number ** 2

square = calculate_square(5)
print(f"5的平方是: {square}")  # 输出: 25

# 3. 多返回值的函数
def get_user_info():
    name = "张三"
    age = 25
    city = "北京"
    return name, age, city

# 使用多个变量接收返回值
user_name, user_age, user_city = get_user_info()

print(f"用户信息: {user_name}, {user_age}岁, 来自{user_city}")

# 使用单个变量接收(返回值会被组织成元组)
user_info = get_user_info()
print(f"用户信息(元组): {user_info}")、

#用户信息(元组) : ('张三',25,'北京')

# 4. 条件返回的函数
def check_number(num):
    if num > 0:
        return "正数"
    elif num < 0:
        return "负数"
    else:
        return "零"

print(check_number(10))   # 输出: 正数
print(check_number(-5))   # 输出: 负数
print(check_number(0))    # 输出: 零
形参
函数定义时来占位置的字符,表示要传入这个参数
- 形参是在函数定义时指定的参数,用于接收函数调用时传递的实参值。
- 形参在函数体内作为变量存在,作用域仅限于函数内部。
实参
函数调用的时候实际传进去的参数,是一个具体的值,==处理函数内部==
- 实参是在函数调用时传入的实际值,实参可以是常量、变量、表达式或==其他函数的返回值==
- 实参的值被传递给形参
位置参数
位置参数调用时根据位置传递给函数。参数的数量和顺序必须与函数定义时一致。
默认参数
默认参数为函数的参数设置默认值。调用函数时,如果没有提供该参数 实参,则使用默认值。
关键字参数
按照形参的参数名进行精确传参,不考虑顺序
示例:
# 形参 & 实参
def greet01(name):
    print(f"Hello, {name}!")

greet01("EaglesLab")
greet01("英格科技")

# 位置参数
def greet02(name, age):
    print(f"Hello, {name}! Age: {age}")

greet02("EaglesLab", 11)

# 默认参数 & 关键字参数 & 可选参数
def greet03(name, site="cloud.eagleslab.com", address="zj"):
    print(f"Site: {site}, Address: {address}")

greet03(address="nj", site="ncloud.eagleslab.com", name="EagelsLab")
动态参数
动态参数在函数定义时接受很多数量的实参。这种特性使得函数可以处理很多实参,不需要在定义时明确列出所有参数。Python 提供了两种主要方式来实现动态参数:*args 和 **kwargs。
*args 允许函数接受任意数量的位置参数,这些参数会被收集到一个 ==元组==中。
def sum_numbers(*args):
    total = sum(args)                #  args 是一个元组
    return total

result = sum_numbers(1, 2, 3, 4, 5)  # 可以传入任意数量的参数
print(result)  # 输出: 15
**kwargs 允许函数接受任意数量的关键字参数,这些参数会被收集到一个==字典==中,name =‘ Str ’
def print_info(**kwargs):
    for key, value in kwargs.items():             #  kwargs 是一个字典
        print(f"{key}: {value}")

print_info(name="EaglesLab", age=10, city="China")

# Output:
name: EaglesLab
age: 30
city: China
可以在同一个函数中同时使用 *args 和 **kwargs,但 *args 必须在 **kwargs 之前。
def display_info(*args, **kwargs):
    print("位置参数:", args)             # args   是一个元组
    print("关键字参数:", kwargs)         # kwargs  是一个字典

display_info(1, 2, 3, name="Alice", age=30)

# Output:
位置参数: (1, 2, 3)
关键字参数: {'name': 'Alice', 'age' : 18}==注意==:args是 作为 元组的形参,可调用函数传递参数进去
kwargs是 作为字典的形参,接受关键字实参
命名空间和作用域
命名空间(Namespace)和作用域(Scope),它们帮助我们理解变量的可见性和生命周期。下面将详细解释这两个概念,并展示它们之间的关系。
命名空间
命名空间是一个容器,用于存储变量名(或标识符)与对象(值)之间的映射关系。命名空间确保了变量名的唯一性,不同的命名空间可以包含同名的变量而不会产生冲突。
类型
-
内置命名空间:包含 Python 内置的函数和对象,如
len()、print()等 -
全局命名空间:模块级别的命名空间,包含模块中定义的变量和函数
-
局部命名空间:函数内部的命名空间,包含函数内部定义的变量
作用域链
作用域链是指在查找变量时,Python 按照一定的顺序查找变量的规则。它遵循 LEGB 规则:
- Local (局部作用域):当前函数内定义的变量。
- Enclosing (包围作用域):外层函数中的局部变量。
- Global (全局作用域):模块级别定义的变量。
- Built-in (内置作用域):Python 内置的名字,如
len()、print()等

==注意==:print( )等在所有情况都可用,为内置的,就区分全局和局部作用域就行
global 和 nonlocal 关键字
global 关键字用于在==函数内部声明==一个变量是==全局变量==,从而允许你在函数内部对其进行修改。
x = 10                  # 全局变量

def modify_global():
    global x            # 声明 x 为全局变量
    x = 20              # 修改全局变量

modify_global()         # 改了   x=20
print(x)                # 输出: 20
如果不使用 global,在函数内部直接赋值会创建一个新的局部变量,而不会影响全局变量。
x=20
def try_modify():
    x = 30  # 创建一个局部变量 x,未声明为 global
    print(x)  # 输出: 30

try_modify()  # 输出:30
print(x) # 输出: 20,仍然是全局变量的值对可变数据类型(list,dict,set)可以直接引用不用通过 global
li = [1,2,3]
dic = {'name':'aaron'}

def change():
    li.append(4)
    dic['age'] = 18
    print(dic)
    print(li)

change()      # 输出:print(dic)和print(li)
print(dic)    # 同样输出2个print
print(li)
nonlocal 关键字用于在嵌套函数中声明一个变量是外层函数的局部变量。它允许内层函数修改外层函数的变量。
在局部作用域中,对父级作用域变量修改,从那层及以下此变量全部发生改变。
def outer_function():
    x = 10  # 外层函数的局部变量

    def inner_function():
        nonlocal x  # 声明 x 为外层函数的局部变量
        x = 20      # 修改外层函数的变量

    inner_function()
    print(x)  # 输出: 20

outer_function() #输出: 20==注意==:nonlocal 仅在嵌套函数中有效,不能用于声明全局变量
函数的嵌套
函数的嵌套,内层函数可以访问外层函数的变量,但是外层函数不可访问内层函数的变量
嵌套调用
嵌套调用指的是在一个函数内部调用另一个函数,使用另一个函数的功能

闭包函数
==内部函数==包含对==外部作用域==而非全局作用域变量的引用,该内部函数称为闭包函数
- 嵌套函数:闭包函数通常是在另一个函数内部定义的。
- 持有外部变量:闭包可以访问其外部函数的局部变量,即使外部函数已经执行完毕。
- 状态保持:闭包允许你在多个函数调用之间保持状态。
def func():
    name = '张三'
    def inner():
        print(name)
    return inner
#  首先函数体最终作用是在终端里print(),同时可以用变量接受返回值,用f()来调用函数实现输出,返回值和输出并不相干
f = func()
f()
==注意==:通过调用外部函数得到==内部函数名返回值==,再次f ( )调用内部函数
判断闭包函数
判断闭包函数的方法 __closure__
def func():
    name = 'EaglesLab'
    def inner():
        print(name)
    return inner

f = func()
print(f.__closure__)    #  打印出的内容非空,说明该函数是闭包函数

name = 'EaglesLab'
def func():

    def inner():
        print(name)
    return inner

f = func()

print(f.__closure__)    # None,说明该函数没有应用外部作用域的变量,不满足闭包函数的条件
案例:获取网页内容
我们需要多次访问一个静态网站,使用==闭包函数==将第一次访问到的网页内容==封装到外部作用域的变量==中,以后我们只需要调用该变量就可
用==闭包的方式==改写如下:
from urllib.request import urlopen

def func():
    content = urlopen('https://myip.ipip.net').read().decode('utf-8')
    def inner():
        print(content)
    return inner

f = func()
for i in range(5):
    f()

print(f.__code__.co_freevars)
==注意==:第一次访问的内容封装到content变量里,里面定义内部函数:打印内容,之后需要用到内容就调用内部函数
Python装饰器
装饰器,可以在不修改函数代码的情况下,动态地修改函数。装饰器本质上是一个函数,它接受一个函数作为参数并返回一个新的函数。
已知有一个函数 func1(),作用是输出一句话。现在我们想要给他增加额外的功能。但是为了保障已有功能的稳定,不能更改原函数。
def func1():
    print("in func1")

# 新的需求,能够打印如下内容...
# hello world
# in func1                     中间这个是之前定义的函数,可直接在另一个函数体内调用
# hello python

# 实现
def func2(func):
    def inner():
        print("hello world")
        func()        #  就是前一个函数调用,这个是基础内容不能更改,其他代码是新增加的功能
        print("hello python")
    return inner

return_func_name = func2(func1)  # inner
return_func_name()   # 相当于直接调用闭包函数的内部函数
理解装饰器

==注意==:最后的func1=inner,属于直接调用内部函数,@传进去的函数作为内部函数代码块运行
装饰带多个参数的函数
利用了函数里面的动态参数进行传参
def my_decorator(func):
    def wrapper(*args, **kwargs):
        # 打印传入的参数
        print(f"调用 {func.__name__} 函数,参数: {args}, 关键字参数: {kwargs}")
        # 调用原始函数并获取结果
        result = func(*args, **kwargs)
        # 打印返回结果
        print(f"{func.__name__} 函数返回: {result}")

        return result
    return wrapper

@my_decorator
def add(x, y):
    """返回两个数的和"""
    return x + y

# 测试
result = add(5, 3)
print(f"最终结果: {result}")
#输出:调用add函数,参数(5,3),关键字参数:{}
add函数返回:8
最终结果8
wraps装饰器
wraps装饰器用于保留被装饰函数的元数据(如函数名称,属性…..),专为装饰器设置的辅助装饰器,让被装饰函数保持原来那个函数

==注意==:wraps(fn)的作用是把原始函数func1()复制到装饰器的内部函数inner()上,让内部函数被执行看起来像原来的函数
多个装饰器装饰一个函数

装饰器固定结构
from functools import wraps

def decorator_with_args(param):
    def actual_decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            print(f"装饰器参数: {param}")
            return func(*args, **kwargs)
        return wrapper
    return actual_decorator

@decorator_with_args("配置参数")
def my_function():       ##     最后直接调用  my_function()函数得到封装的函数
    pass
迭代器与生成器
可迭代对象
使用 for i in xxx 对字符串、列表、元组、字典、集合进行循环取值的过程称为遍历,也叫做迭代
i = [1, 2, 3, 'a', 'b', 'c']
for i in li:
    print(i)

str = "hello,world"
for j in str:
    print(j)

dic = {'name': 'nls', 'age': 18, 'job': 'teacher'}
for k,v in dic.items():
    print(k,v)
定义
可迭代对象是能够通过迭代逐一返回其元素的对象,它必须满足以下两个条件:
- 实现
__iter__()方法,返回一个迭代器对象 - 实现
__getitem__()方法,支持从索引0开始的顺序访问
迭代器
迭代器是一个对象,记录遍历的位置。
可迭代对象可以通过 __iter__ 方法返回一个迭代器。我们在迭代一个可迭代对象的时候,实际上就是先获取该对象提供的一个迭代器,然后通过这个迭代器来依次获取对象中的每一个数据
上面讲到迭代是访问集合元素的一种方式,而迭代器是一个可以记住遍历的位置的对象。迭代器对象从集合的第一个元素开始访问,直到所有的元素被访问完结束,迭代器只能往前不会后退
==注意==:就是一个对象,用来记录遍历的位置
迭代器协议
迭代器遵循迭代协议,内部主要定义了 __iter__() 和 __next__() 两个方法
__iter__()方法用于初始化一个迭代器,返回迭代器本身__next__()方法用于迭代下一个数据,当没有元素可返回时,抛出StopIteration异常。
初始化迭代器
list1 = [1,2,3,'a','b','c']

list_iter = list1.__iter__()    # list 是可迭代对象,这里我们调用 iter 方法初始化一个迭代器l ist_iter
item = list_iter.__next__()     # 这里通过 next 方法来获取下一个数据
print(item)
item = list_iter.__next__()
print(item)
item = list_iter.__next__()
print(item)
item = list_iter.__next__()
print(item)
item = list_iter.__next__()
print(item)
item = list_iter.__next__()
print(item)
如果超出迭代范围,会触发 StopIteration异常,我们可以加上异常处理,取完值后自动停止
list1 = [1,2,3,'a','b','c']

list_iter = list1.__iter__()
while True:
    try:
        print(next(list_iter))        # 这里是 next 方法的另一种写法
    except StopIteration:
        print('迭代完成')
        break
for 循环的本质
我们常用的 for 循环其实本质上就是迭代器协议的一种具体实现,为我们提供了一个遍历的迭代元素的方法
工作原理:
当你使用 for 循环遍历一个可迭代对象时,实际上发生了以下几个步骤:
-
调用
__iter__()for循环首先调用对象的__iter__()方法,获取一个迭代器对象。
-
调用
__next__()- 然后,
for循环在迭代器上反复调用__next__()方法,以获取下一个元素。
- 然后,
-
处理
StopIteration- 一旦
__next__()抛出StopIteration异常,for循环停止迭代。
- 一旦
生成器
就是一种迭代器
生成器函数:含有yield关键字
生成器是一个函数,但与普通函数不同,它使用 yield 关键字来返回值。每次调用生成器函数时,它会从上次 yield 的地方继续执行,直到遇到下一个 yield 或函数结束
==调用生成器函数==不会得到返回的具体的值,而是得到一个迭代器,每一次获取这个迭代器值,就能推动函数的执行,获取新的返回值。直到函数执行结束。
def numbers(n):
    """生成从 1 到 n 的自然数"""
    for i in range(1,n+1):
        yield i

for i in numbers(10):
    print(i)
==注意==:生成器函数本质就是把函数切割为片段,分段手动执行, ==return==关键字不生效
惰性求值
生成器在需要时生成值,而不是一次性计算和返回所有值。这可以节省内存,特别是处理大型数据集时
<img src=”https://li-zheng-blog-2026.oss-cn-shanghai.aliyuncs.com/blog/%E6%83%B0%E6%80%A7%E6%B1%82%E5%80%BC.png” />

send
- send 获取下一个值的效果和next基本一致
- 在获取下一个值的时候,给上一个 yield 的位置传递一个数据
- 使用 send 的注意事项
- 第一次使用生成器的时候 是用 nex t获取下一个值
- 最后一个 yield 不能接受外部的值
def generator():
    print(123)
    content = yield 1
    print('欢迎来到',content)
    print(456)
    yield 2

g = generator()
ret = g.__next__()
print('***',ret)     # 输出123,1
ret = g.send('英格科技')
print('***',ret) # 输出 欢迎来到,英格科技==注意==:send与next关系:1.next(g)等价于g.send(None),都驱动生成器运行到下一个yield,但send(value)能把里的value传给上一个yield关键字前面,然后运行第二次:从content=英格科技,print,print,到yield 2
本质就是:生成器函数是静态的,要添加值就用send方法把值分段添加到函数里分段执行
Python推导式
列表推导式
列表推导式主要是用于按照我们指定的内容填充,生成一个新的列表,基本语法如下:
new_list = [ (expression)   for item in iterable      (if condition) ]
# expression    为想得到的列表内容
# if condition  为 元素满足条件满足才能返回值
示例
# 生成0~10的一个列表
l = [i for i in range(11)]
print(l)                # 输出: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

# 生成平方数的列表
squares = [x ** 2 for x in range(10)]
print(squares)          # 输出: [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]

# 生成偶数的列表
even_numbers = [x for x in range(20) if x % 2 == 0]
print(even_numbers)      # 输出: [0, 2, 4, 6, 8, 10, 12, 14, 16, 18]
案例
- 找到嵌套列表中名字含有两个及以上‘a’的所有名字
fruits = [['peach','Lemon','Pear','avocado','cantaloupe','Banana','Grape'],
          ['raisins','plum','apricot','nectarine','orange','papaya']]

print( [ (name) for lst in fruits  for name in lst  (if name.count('a') >= 2) ] )
/
# Output:
['avocado', 'cantaloupe', 'Banana', 'papaya']
集合推导式
集合推导式用于生成一个新的集合,它的语法与列表推导式类似,但使用大括号 { }
new_set = { (expression) for item in iterable (if condition) }示例
# 生成平方数的集合
squares_set = {x ** 2 for x in range(10)}
print(squares_set)  # 输出: {0, 1, 4, 9, 16, 25, 36, 49, 64, 81}

# 生成唯一的字符集合
unique_chars = {char for char in "hello world"}
print(unique_chars)  # 输出: {'h', 'e', 'l', 'o', ' ', 'r', 'w', 'd'}
案例
计算列表中每个值的平方,自带==去重==功能
l = [1,2,3,4,1,-1,-2,3]

squared = {x**2  for x in l }
print(squared)

# Output:
{16, 1, 4, 9}
字典推导式
我们可以使用字典推导式生成一个新的字典
new_dict = { (key_expression:value_expression) for item in iterable (if condition) }示例
# 生成平方数的字典
squares_dict = { (x:x**2) for x in range(10) }
print(squares_dict)  # 输出: {0: 0, 1: 1, 2: 4, 3: 9, 4: 16, 5: 25, 6: 36, 7: 49, 8: 64, 9: 81}
案例
- 将一个字典的 key 和 value 对调
dic1 = {'a':1,'b':2}

dic2 = { dic1[k]: k  for k in dic1 }
print(dic2)- 合并大小写对应的value值,将k统一成小写
dic1 = {'a':1,'b':2,'y':1, 'A':4,'Y':9}

dic2 = {k.lower():dic1.get(k.lower(),0) + dic1.get(k.upper(),0) for k in dic1.keys()}
print(dic2)
内置函数和匿名函数
内存相关
hash()
获取一个对象(可哈希对象:int,str,bool,tuple)的哈希值
print(hash(12322))
print(hash('123'))
print(hash('arg'))
print(hash('aaron'))
print(hash(True))
print(hash(False))
print(hash((1,2,3)))
id()
用于获取对象的内存地址
print(id('abc'))
print(id('123'))
==注意==:hash( ) 只生成哈希值,然后哈希表按照编号快速定位,就像一个新华字典,根据哈希值找对应的位置
id( )返回对象的内存地址,不会变,判断两个变量a和b,是否相同,a==b,就是再比较两个的内存地址是否相同
数据结构相关操作
filter()
过滤序列中不符合条件的元素,返回由符合元素组成的新的迭代器


map()
将指定函数应用于可迭代对象中的每个元素,并返回一个迭代器。这个函数非常有用,可以简化对数据的转换和处理
def square(x):
    return x**2

list1 = [1,2,3,4,5,6,7,8]

ret = map(square,list1)
print(ret)

for i in ret:
    print(i)
匿名函数
匿名函数是指没有名称的函数,通常使用 lambda 关键字定义。匿名函数可以用于需要函数作为参数的场合,比如在 map()、filter() 和 sorted() 等函数中
语法
lambda 参数: 表达式- 参数可以有多个,用逗号隔开
- 匿名函数不管逻辑多复杂,只能写一行,且逻辑执行结束后的内容就是返回值
- 返回值和正常的函数一样可以是任意数据类型
示例:
#   自定义函数的方法
def func1(n):
    return n ** n

print(func1(10))

# 换成匿名函数
func2 = lambda n: n ** n
print(func2(10))
案例
- 计算两个数的和
add = lambda x, y: x + y
print(add(2, 3)) # 输出: 5- 配合
map()使用
list1 = [1,2,3,4,5,6,7,8]

ret = map(lambda x: x ** 2,list1)
print(ret)

for i in ret:
print(i)- 配合
filter()使用
ret = filter(lambda x: x % 2 == 0,[1,2,3,4,5,6,7,8,9,10])
print(ret)
for i in ret:
    print(i)
模块和包
模块
模块(module) 是一个包含 Python 代码的文件,通常以 .py 结尾,模块可以包含变量、函数、类,甚至其他模块。通过模块,我们可以将代码组织成不同的文件,更好地管理和复用代码。
模块可以分为以下几类:
- 自定义模块:用户自己编写的模块
.py - 标准库模块:Python 自带的模块,如
math、os、sys等 - 第三方模块:由其他开发者编写的模块,通常可以通过
pip安装
自定义模块
自定义模块是 Python 中一个重要的代码组织方式,它允许开发者将相关的代码(包括函数、类和变量)封装到一个 .py 文件中。通过自定义模块,我们可以实现代码的重用和模块化开发,避免代码重复,提高代码的可维护性。自定义模块可以被其他 Python 程序通过 import 语句导入使用,每个模块都有自己独立的命名空间,这样可以避免不同模块之间的命名冲突
示例1:自定义模块
# my_module.py

print("This is my moudle....")

def greet(name):
    return f"Hello, {name}!"

def add(a, b):
    return a + b

PI = 3.14159

# test.py
import my_module

# 使用 my_module 中的函数和变量
print(my_module.PI)
print(my_module.greet("EaglesLab"))
print(my_module.add(5, 3))

# 模块别名
import my_module as mm

print(mm.greet("EaglesLab"))
示例2:根据用户输入导入不同自定义模块
# mysql.py
def sqlparse():
    print('from mysql sqlparse')

# oracle.py
def sqlparse():
    print('from oracle sqlparse')

# test.py
db_type = input('>>: ')
if db_type == 'mysql':
    import mysql as db
elif db_type == 'oracle':
    import oracle as db

db.sqlparse()
模块导入
# 导入多个模块1
import sys
import os
import re

# 通过 from 导入模块
# from filename import function
from my_module import greet, add

# 覆盖导入模块中的同名函数
def add():
    pass
==注意==:导入需要的功能进行,增加可读性,不要一次导入全部
python 全局变量 __name__,用来控制 .py 文件在不同的应用场景下执行不同的逻辑
- 当文件被当做脚本执行时:
__name__ 等于'__main__' - 当文件被当做模块导入时:
__name__等于模块名
def fib(n):
    a, b = 0, 1
    while b < n:
        print(b, end=',')
        a, b = b, a+b
    print()

if __name__ == "__main__":      #  被当作脚本执行
    print(__name__)
    num = input('num :')
    fib(int(num))

print(globals())
==注意==:__name__是区分’主动执行’和’被动导入’的方法
模块的搜索路径
Python 在导入模块时会按照一定的顺序搜索模块所在的位置。主要的搜索路径包括:
- 当前目录:Python 首先在当前目录下查找要导入的模块
PYTHONPATH环境变量:包含一系列目录名,可以通过设置此环境变量来添加额外的模块搜索路径- 标准库目录:Python 安装时自带的标准库所在的目录
- site-packages 目录:第三方模块安装的默认位置
设置PYTHONPATH环境变量:
# Linux/macOS
export PYTHONPATH=/path/to/your/modules:$PYTHONPATH

# Windows
set PYTHONPATH=C:pathtoyourmodules;%PYTHONPATH%
注意事项:
- 不建议在代码中直接修改
sys.path,最好通过环境变量或==安装包==的方式管理模块路径 - 搜索路径的优先级按照
sys.path列表中的顺序,越靠前优先级越高 - 在导入模块时,一旦在某个路径下找到了对应的模块,就会停止搜索
==注意==:安装(包)之后会自动配置路径,原理:当执行 pip install 包 ,包会被安装到Python 的site-packages目录,这个目录就存在于sys.path(模块搜索路径)里,sys.path里本来就有site-packages,你只是往里添加了文件(不改sys.path)
常规安装:往已有目录里放包形成子目录,不改变sys.path目录列表,==列表里的目录是平级关系==
开发模式安装:自动添加.pth文件相当于一个新目录
包(Packages)
Python 包(Package)是一个==包含 __init__.py 文件==的目录,它用于组织和管理相关的Python模块
包,使得大型项目中的模块组织更加清晰。通过__init__.py显示声明,解释器自动识别为包
包(目录树:结构)

文件内容
#文件内容

# policy.py
def get():
    print('from policy.py')

# versions.py
def create_resource(conf):
    print('from version.py: ',conf)

# manage.py
def main():
    print('from manage.py')

# models.py
def register_models(engine):
    print('from models.py: ',engine)
使用 from 导入包
from 后 import 导入的模块,必须是明确的一个不能带点,否则会有语法错误,如:from a import b.c是错误语法
from glance.db import models
from glance.db.models import register_models

models.register_models('mysql')
register_models('mysql')
==注意==:到时候想用哪个模块就导哪个,不用全导入,要精确性。
绝对导入和相对导入
绝对导入:太麻烦,不太好
相对导入:参照sys.path[0]起始开始查找,称之为相对导入
- 符号:
.代表当前所在文件的文件夹,..代表上一级文件夹,...代表上一级的上一级文件夹 - 优点:导入更加简单
- 缺点:只能在导入包中的模块时才能使用

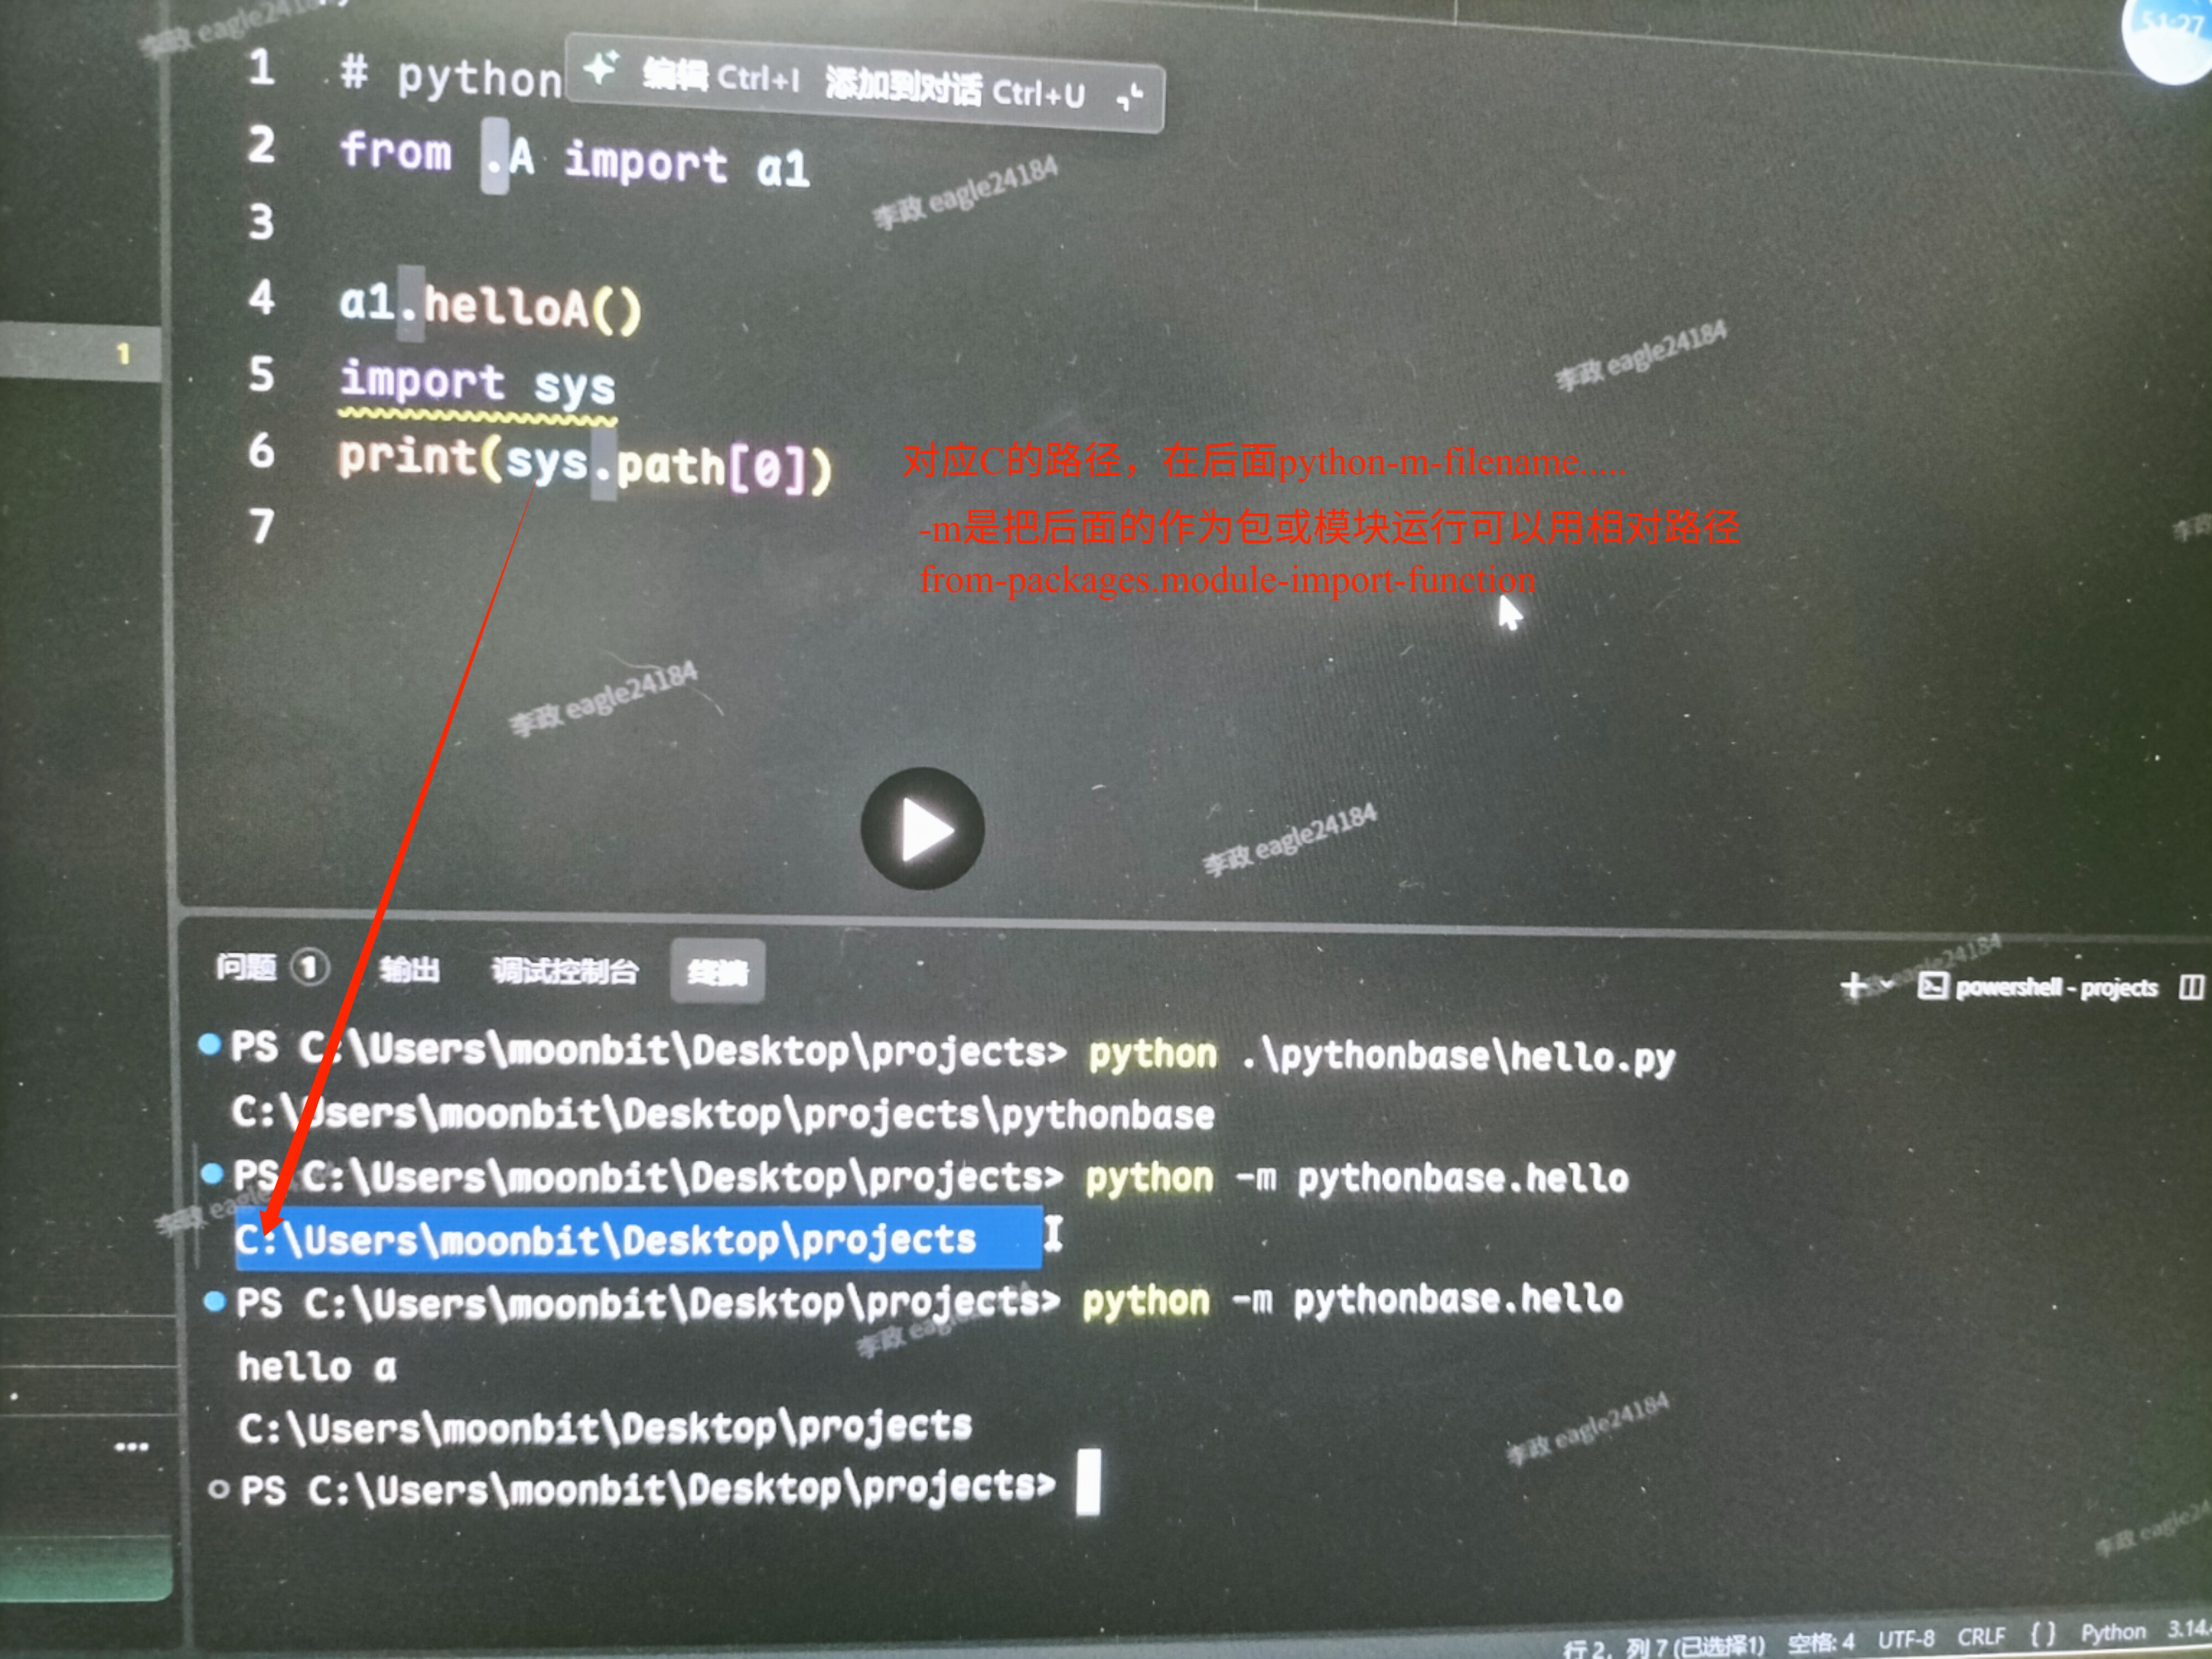
==注意==:就用python -m packages.module.filename这样可以动态修改
虚拟环境:包隔离
通过操作系统路径查找机制,与全局环境隔离。能解决不同包版本冲突问题,全局环境只能安装一个版本,而虚拟环境允许你为每个项目分别安装任意版本,互不干扰。==路径隔离==:为你提供了一个干净、独立、互不干扰的工作空间

优势
-
不同项目依赖同一个包的不同版本时,全局环境只能安装一个,会导致一个项目能跑,另一个项目报错。
-
可以直接执行pip命令,全局环境会报错
-
项目依赖包和全局依赖包,全局包杂乱无章,虚拟环境项目包独立,互不干扰
-
如果不用虚拟环境,全局环境默认路径通常在:
· **C:Users你的用户名AppDataLocalProgramsPythonPython3xLibsite-packages** ·或者是 Python 安装目录下的 Libsite-packages 文件夹。 -
文件默认安装到系统的全局Python环境,==所以要创建虚拟环境,本质是复制出一套隔离的Python环境,通过优先修改搜索路径
sys.path[0],将包安装到项目专属目录而非全局,从而避免不同项目间的版本冲突==
Python版本隔离:uv
uv原生支持 Python 版本隔离,uv把 Python 版本锁定在项目内部,即使系统 Python 升级(如 3.10 → 3.12),uv管理的环境也纹丝不动,项目可能遇到不同版本Python
hashlib模块(算法摘要):加密
Python 的 hashlib 模块提供了多种安全哈希和消息摘要算法的接口。这些算法用于生成数据的唯一哈希值,广泛应用于数据完整性校验、密码存储等领域
==摘要算法==又称哈希算法、散列算法。它通过一个函数,把任意长度的数据转换为一个长度固定的数据串(通常用16进制的字符串表示)。
摘要算法就是通过摘要函数对任意长度的数据计算出固定长度的摘要,目的是为了发现原始数据是否被人篡改过,进行校验
摘要算法之所以能指出数据是否被篡改过,就是因为摘要函数是一个单向函数,计算摘要很容易,但通过摘要反推数据却非常困难。而且,对原始数据做一个 bit 的修改,都会导致计算出的摘要完全不同。
hashlib 支持多种哈希算法,包括:
| 算法 | 说明 |
|---|---|
MD5 |
已破解,不安全,仅用于非安全校验(如文件去重) |
SHA-1 |
已破解,不安全,已弃用 |
==SHA-256 / SHA-512== |
安全,推荐用于通用哈希、数字签名、证书等 |
SHA-3 (如 SHA3-256) |
新一代安全哈希算法,抗碰撞能力强(Python 3.6+) |
BLAKE2 (blake2b, blake2s) |
比SHA-3更快,可选输出长度,同样安全(Python 3.6+) |
| SHAKE (128/256) | 可扩展输出长度的哈希函数(XOF)(Python 3.6+) |
PBKDF2 |
密钥派生函数,用于密码存储(通过 hashlib.pbkdf2_hmac 调用) |
基本用法
import hashlib

# sha256_hash = hashlib.sha256(b'xxxx')
sha256_hash = hashlib.sha256()   # 创建一个 SHA-256 哈希对象
md5_hash = hashlib.md5()

data = b"123456"

sha256_hash.update(data)         #  更新哈希对象

sha256_digest = sha256_hash.hexdigest()    # 获取哈希值

print("SHA-256:", sha256_digest)
加盐
import hashlib
import os

salt = os.urandom(16)   # 生成随机盐
password = b"123456"

hashed = hashlib.pbkdf2_hmac('sha256', password, salt, 10)  # 使用 sha256 和  10次迭代
print(hashed)

import binascii
print(binascii.hexlify(stored_hash).decode('utf-8'))    # 转成十六进制表示
注意事项
- 不可逆性:哈希函数是不可逆的,意味着无法从哈希值恢复原始数据。
- 碰撞:不同的输入可能生成相同的哈希值(称为碰撞),但现代的哈希算法力求使碰撞的概率尽量低。
- 安全性:对于密码存储,建议使用更安全的哈希算法(如
SHA-256或更高版本)和适当的盐值(salt)来增强安全性。
使用场景
- 数据完整性:用于验证文件或数据在传输过程中未被篡改。
- 密码存储:将用户密码的哈希值存储在数据库中,而不是明文密码。
- 数字签名:用于创建数字签名,确保数据来源的可靠性。
案例:密码验证
import hashlib
import os

salt = os.urandom(16)
password = b"123456"

stored_hash = hashlib.pbkdf2_hmac('sha256', password, salt, 10)

def verify_password(stored_hash, stored_salt, input_password):
    new_hash = hashlib.pbkdf2_hmac('sha256', input_password, stored_salt, 10)
    return new_hash == stored_hash

pwd = bytes(input('input passwrod: '), encoding='utf-8')

print(verify_password(stored_hash, salt, pwd))
==注意==:校验:密码哈希值匹配密码哈希值
密码串已生成一次摘要,再通过二次加盐拼进去一个随机串,进行二次摘要
md5有对应库进行比对,只能比对简单的
密码验证原理
每个软件都有自己独立的数据库,这个独立的数据库存储了 每个人的用户名(明文)、盐(用户固定唯一的),迭代次数(一般软件开发者自动设置为一个固定参数比如10000),哈希值(根据用户名,密码,盐,迭代次数生成的 ),==密码==不会存储在数据库
==攻击者==:如果数据库泄露了,攻击者可以==拿到数据库的用户(某些或全部)存储信息==,然后可以通过软件不断试密码,这个过程叫:==离线暴力破解==或==离线字典攻击==;有坏情况试出来密码也没事,很多支付软件(银行app,支付宝…)有双重认证(2FA)比如(指纹,人脸识别什么的)
==总结==:加盐+哈希保护的是存储安全,双重认证保护的是 . 两者结合,即使数据库泄露且你的密码被破解,攻击者仍然无法进入你的账户
撞库:
定义:攻击者利用从一处泄露得到的用户名和明文密码,批量尝试登录其他网站或服务。
典型流程:
- 攻击者从网站 A 的泄露数据库中得到一批用户名和密码(例如通过离线破解哈希获得明文)。
- 然后编写脚本,用这些组合去尝试登录网站 B、网站 C、邮箱、银行等。
- 由于许多用户在多个平台使用相同的密码,撞库成功率往往不低。
==例如==:银行支付有二次验证,QQ新设备/异常位置时都有二次验证
re正则模块

贪婪和非贪婪:贪婪:吃到最后一个满足条件的;非贪婪:吃到第一个满足条件的就停
==注意==:正则表达式用ai写出来会用就行