计算机组成
cpu(中央处理器):负责执行所有程序的指令,现代cpu都是多核的。==单核运行==:操作系统把你的程序分配给一个核心,即使CPU有8个核,你的程序也只占一个。多核运行:程序内部拆成多个可独立执行的任务,操作系统把它们调度到不同核心上同时执行,真正并行处理,能成倍缩短计算时间
内存:是cpu和硬盘间的缓冲地带,存放当前运行的程序和需处理的数据。它是易失性存储,断电后数据全部丢失. ==内存条==(DRAM动态内存),直接与CPU通过内存总线交换数据,速度远快于硬盘,但慢于CPU cache
硬盘:永久仓库,断电不丢失数据,SSD(固态硬盘):主流,电路读写,安静,无机械部件. 作用:长期存放操作系统、应用程序和用户的文档、照片、视频等所有文件。当要运行时,数据会先从硬盘加载到内存,再由CPU处理
显卡(GPU):视觉输出处理器,图形渲染输出画面,NVIDIA,可进行大规模并行计算
主板:一块集成了各种插槽和接口的巨大电路板,功能:为所有硬件提供物理安装平台和数据与通信通道. 包含:1.芯片组,主板的”交通枢纽”,负责管理数据在CPU,内存,显卡,硬盘,USB接口之间的流通. 2.插槽与接口:提供CPU插槽、内存插槽、PCIe扩展槽、硬盘接口、USB接口等. 3.BIOS/UEFI:主板上固化的最底层程序,负责开机硬件自检、初始化,并引导操作系统
电源:为计算机各部件提供电流
散热器:负责将CPU和GPU这些发热大户产生的热量迅速带走,防止因为过热而降频或损坏。一般涂抹导热硅脂来填平肉眼不可见的缝隙,否则散热效果会大打折扣
计算机组成示意图

.png)


工作原理:开机,电源供电,主板初始化,CPU从硬盘加载系统到内存运行. 程序图形指令发给显卡生成画面。散热器散热
操作系统
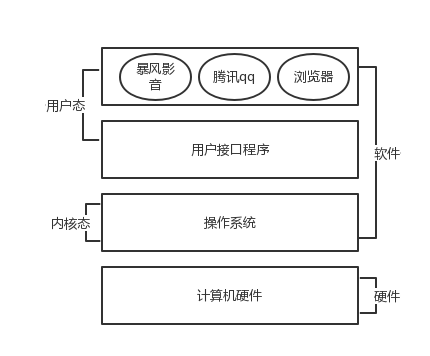
操作系统:(Operating System,简称 OS)是管理和控制计算机硬件与软件资源的计算机程序,是直接运行在“裸机”上的最基本的系统软件,任何其他软件都必须在操作系统的支持下才能运行
操作系统应该分成两部分功能
- 隐藏了丑陋的硬件调用接口(键盘、鼠标、音箱等等怎么实现的,就不需要你管了),为应用程序员提供调用硬件资源的更好,更简单,更清晰的模型(系统调用接口)。应用程序员有了这些接口后,就不用再考虑操作硬件的细节,专心开发自己的应用程序即可。 例如:操作系统提供了文件这个抽象概念,对文件的操作就是对磁盘的操作,有了文件我们无需再去考虑关于磁盘的读写控制(比如控制磁盘转动,移动磁头读写数据等细节)
- 将应用程序对硬件资源的竞态请求变得有序化 例如:很多应用软件其实是共享一套计算机硬件,比方说有可能有三个应用程序同时需要申请打印机来输出内容,那么a程序竞争到了打印机资源就打印,然后可能是b竞争到打印机资源,也可能是c,这就导致了无序,打印机可能打印一段a的内容然后又去打印c…,操作系统的一个功能就是将这种无序变得有序。



IO子系统(珊瑚色):把磁盘、SSD的复杂块操作统一成 read/write/open 几个调用
内存管理(蓝色):MMU+ 页表把物理 RAM 变成每个进程独享的虚拟地址空间
图形子系统(琥珀色):DRM/帧缓冲层隔离 GPU 差异,OpenGL/Vulkan 再往上抽象一层
网络协议栈(青色):Socket API把 TCP/IP/以太网/WiFi的协议细节全部收进内核
输入设备(粉色):evdev/HID 把键盘、鼠标、触摸板、手柄统一成事件队列
==总结==:自上而下的主要关系: 1. 应用程序层(最上层):浏览器、游戏等软件只与“系统调用接口”交互,无需直接操作硬件。 2. 系统调用接口:为上层提供统一入口(如 read、open),隔离了具体硬件实现。 3. 内核子系统(中间核心层): · IO子系统、内存管理、图形子系统、网络协议栈、输入设备 各自负责一类资源 · 它们通过设备驱动层与底层硬件通信 4. 设备驱动层:每个驱动程序对应一类硬件(如磁盘驱动、网卡驱动),负责将内核的通用操作转换为硬件具体指令。 5. 硬件层(最底层):实际的物理设备(磁盘、内存、GPU、网卡、键盘等)。 核心关系逻辑: 向下屏蔽差异:驱动层让内核子系统无需关心不同厂商硬件的细节 ,向上提供抽象:系统调用给应用程序简洁的接口(比如“文件”抽象了磁盘读写) · 横向协调资源:各子系统内部会管理多个应用的竞争请求(如打印机有序打印),将无序变得有序
用户态和内核态
主要区别在于==能不能执行特权指令==
==提权==:正常情况:用户态程序如果没通过权限检查,内核会直接拒绝,无法获得内核态高权限。
恶意提权:利用漏洞,即使没通过检查,也能让内核态执行高权限操作(如修改进程凭证为 root),从而获得本不该有的高权限
1. 正常提权:检查通过 → 合法获得高权限 2.恶意提权:检查被绕过 → 非法获得高权限
网络基础知识
OSI七层模型


OSI是理论标准,TCP/IP是事实标准,五层是工程和教学的折中,更常用,每一层的==唯一标识==如下:
数据链路层——MAC地址 机器A:MAC AA:AA:AA:AA:AA:AA,交换机
网络层——IP地址 (192.168.1.10)(局域网1),路由器
传输层——端口号 (80),HTTP(网页),操作系统
应用层——PID(2345)或(5678),自己写的程序
简单路由器示例


==总结==: 1.每个网络接口(网卡)都有一个出厂固定的MAC地址。路由器有多个接口(比如LAN口、WAN口),所以它有多个不同的MAC地址,每个接口一个。你电脑上如果只有一个有线网卡和一个Wi-Fi网卡,那就有两个不同的MAC地址
2.TCP是协议,端口是TCP头部里的一个字段。==TCP用端口来区分进程(运行的应用程序,如QQ,微信,音乐,b站视频)==:告诉接收方的操作系统,数据应该交给哪个应用程序 。 端口的核心作用:当数据包经过IP和MAC地址送到正确的电脑后,端口负责把数据交给正确的进程。
3.电脑MAC → 路由器入口MAC → 路由器出口MAC → 目标MAC
私有地址和公有地址
- 私有地址之间不能直接传输,只有公有可直接传输
- 所以,“公有
IP+ 临时端口” 就是两个私有设备之间的桥梁。 没有这个中间态,数据包无法穿越 NAT 到达私有设备 - NAT 路由器只记录内网设备主动访问外网(公有地址)时建立的==映射==
- 私有设备之间的直接通信,并不是私有地址到私有地址,而是 私有地址A(私有
ip+固有端口) → 自己的(公有IP+临时端口A) → 对方的(公有IP+临时端口B) → 私有地址B(私有ip+固定端口),==所以是通过这个NAT建立的映射保存记录来实现传输的==
具体工作协同流程
- 发送方(A)
数据从应用层往下走:TCP加端口(保可靠、找进程) →IP加地址(最终目的) → MAC加下一站地址(当前链路)。
封装完成,发出去。 - 路由器(B)
收包后只剥MAC头,看IP决定下一跳,然后重写MAC头(源变自己出口,目标变下一站)。IP和TCP头原封不动。 - 接收方(C)
从下往上逐层剥头:MAC匹配自己 →IP匹配自己 → 按TCP端口交给对应进程(如Web服务)。
若数据完整有序,则应用层收到原始数据。
核心规则:
· IP全程不变(最终地址)
· MAC每跳更换(逐段寻路)
· 端口固定(区分进程)
· TCP保证可靠(不丢、不乱、不错)
· 封装与解封装顺序严格相反(加头→去头)


代码示例


域名系统(dns)
域名系统的本质:一个分布式,层次化的命名与映射系统。==把人类易记的域名==(如baidu.com)==转换成机器寻址用的IP地址==
(如110.242.68.66) . 用直观的英文单词(baidu.com域名)DNS协议自动返回 ip (110.242.68.66)
网络编程可操作的层:
对于开发者来说,我们只能站在==应用层==做操作,一般以下面两个任务为主 1.基于HTTP协议做客户端和服务端开发(非常非常高频,Java后端和web前端以HTTP协议为核心) 2.基于socket开发应用层协议和解析应用层协议(很少很少接触到,一般在中间件或基础软件研发才会接触到)
Socket网络编程
实际上从传输层开始以及以下,都是操作系统帮咱们完成下面的各种包头封装的过程


==Socket的本质和革命性意义==
本质:
Socket是操作系统提供给用户进程的、对网络通信端点的一个抽象。 它把复杂的TCP/IP协议栈(三次握手、滑动窗口、拥塞控制、重传、校验等)封装成一组简单的、类似文件操作的API(socket, bind, listen, accept, connect, send, recv)。
意义:
核心概念
- Socket(套接字):网络通信的端点,支持不同主机间的进程通信
- 协议类型:
- TCP:
- UDP:
- 地址族:…
TCP 协议工作流程


服务端
实现步骤:
- 创建 Socket 对象:
socket.socket(socket.AF_INET, socket.SOCK_STREAM) - 绑定地址与端口:
bind(('0.0.0.0', 12345))(0.0.0.0 表示监听所有 IP) - 监听连接:
listen(5)(参数为最大等待连接) - 接收连接:
accept()返回客户端 Socket 和地址 - 数据交换:
send()和recv()方法收发数据 - 关闭连接:
close()释放资源
客户端
实现步骤:
- 创建 Socket 对象:
socket.socket(socket.AF_INET, socket.SOCK_STREAM) - 连接服务器:
connect(('127.0.0.1', 12345)) - 数据交换:同服务器端
send()和recv()
示例代码
# server.py 代码
import socket

server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)

server.bind(("127.0.0.1", 8080))

server.listen(5)

conn, client_addr = server.accept()
print(conn, client_addr, sep="n")

from_client_data = conn.recv(1024)
print(from_client_data.decode("utf-8"))

conn.send(from_client_data.upper())

conn.close()

server.close()


# client.py 代码
import socket

client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)

client.connect(("127.0.0.1", 8080))

client.send("hello".encode("utf-8"))

from_server_data = client.recv(1024)

print(from_server_data)

client.close()TCP与UDP协议区别
- TCP是可靠传输协议(稳定可靠): 用于网页浏览,文件传输,电子邮件,数据库连接;
UDP是不可靠传输协议(会偶尔丢包,追求低延迟):游戏,实时音视频,直播(虎牙,b站等)
粘包问题
==原因==:
发送方、接收方 和 两个维度分解。
1. 发送方原因:TCP 协议栈的优化行为
- Nagle 算法(默认开启):
为了减少小包数量,TCP 会等待一小段时间(通常200ms),如果发送缓冲区中有多个小消息,或者等待期间收到了之前消息的ACK,就会将多个小消息合并成一个 TCP 段发出。
→ 导致:多个应用层消息粘在一起(粘包)。 - 最大分段大小(MSS)限制:
TCP 段的数据部分不能超过 MSS(通常由路径 MTU 决定,典型值 1460 字节)。如果一个应用层消息大于 MSS,TCP 会将其拆分成多个段。
→ 导致:一个消息被分成多次发送(拆包)。 - 发送缓冲区策略:
应用程序write的数据先复制到内核发送缓冲区。TCP 会按照自身的拥塞控制和流量控制来决定何时真正发送、发送多少。即使你分两次write,也可能被一次性发出。
2. 接收方原因:应用程序读取不及时
- 接收缓冲区堆积:
内核将收到的 TCP 段存入接收缓冲区。如果应用程序调用recv不够快,多个消息就会堆积在缓冲区中。当应用程序最终调用recv读取一个大块时,可能一下子取走多个消息。
→ 导致:粘包。 - 用户缓冲区长度限制:
调用recv(buf, len)时,若len小于消息的实际长度,则只能读出部分数据,剩余数据留在缓冲区中。下次再读时,可能读到某个消息的后半部分,或者读到下一个消息的前半部分。
→ 导致:拆包(也叫半包)。
==本质==
TCP 是面向字节流的协议,它只保证字节序列的有序、可靠传输,但不维护、不识别应用层消息之间的边界。 因此,多个应用层消息在字节流中可能“粘”在一起,也可能一个消息被拆成多个片段,“粘包”和“拆包”是同一本质的两种表现形式。
解决方案
一.直接使用已封装好消息边界的库/协议
不直接操作裸 Socket,而是==选用已经内置了粘包处理能力==的:


二、为什么使用(原因)
三.优点(使用带来的好处)


==总结==:使用现成库/协议解决粘包,就是用“行业标准方案”替代“手写轮子”,换来高效率、高可靠、低维护成本的工程收益。在实际项目中,除非有极轻量的私有协议需求,否则这永远是首选做法。
示例代码
Demo1
通过 连续发送小数据包 和 接收缓冲区合并 的场景模拟粘包现象:
# 服务端代码(连续发送两次数据)
import socket

server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
server.bind(('0.0.0.0', 8888))
server.listen(5)

print("服务端已启动,等待客户端连接...")

conn, addr = server.accept()
print(f"客户端 {addr} 已连接")

try:
    # 连续发送两次数据(未处理粘包)
    conn.send(b'Hello')  # 第一次发送
    conn.send(b'World')  # 第二次发送(可能合并到缓冲区)
except KeyboardInterrupt:
    print("服务端主动终止")
finally:
    conn.close()
    server.close()

# 客户端代码(一次性接收数据)

import socket

client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
client.connect(('127.0.0.1', 8888))

try:
    # 一次性接收数据(可能合并两次发送的内容)
    data = client.recv(1024)
    print(f"接收到的数据: {data.decode()}")  # 预期输出可能是 'HelloWorld'
except ConnectionResetError:
    print("服务端已关闭连接")
finally:
    client.close()
现象解释
Nagle算法:发送端连续调用send()发送小数据包,可能将两次发送合并为一个包。- 缓冲区机制:接收端
recv(1024)的缓冲区较大,一次性读取了所有待接收数据
Demo2
通过 大缓冲区发送 + 小缓冲区接收 的场景模拟接收不完整问题:
# 服务端代码(发送 10KB 大数据包)
import socket

server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
server.bind(('0.0.0.0', 8888))
server.listen(5)

print("服务端已启动,等待客户端连接...")
conn, addr = server.accept()

try:
    # 发送 10KB 数据(超过常规接收缓冲区)
    big_data = b'A' * 1024 * 10  # 10KB
    conn.sendall(big_data)
    print(f"已发送 {len(big_data)} 字节数据")
except KeyboardInterrupt:
    print("服务端主动终止")
finally:
    conn.close()
    server.close()

# 客户端代码(仅接收 4KB 数据)
import socket

client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
client.connect(('127.0.0.1', 8888))

try:
    # 设置接收缓冲区为 4KB,且仅接收一次
    partial_data = client.recv(4096)  # 只接收一次
    print(f"实际接收长度: {len(partial_data)} 字节")  # 输出 4096,残留 6KB 未接收
except ConnectionResetError:
    print("服务端已关闭连接")
finally:
    client.close()
现象解释
- TCP 流式特性:TCP 将数据视为连续字节流,无边界标识
- 缓冲区限制:
recv()方法一次性读取的字节数受参数限制,未循环接收导致残留
struct模块
把一个类型,如数字,转成固定长度的 bytes


常见用法
import struct

# 将一个数字转化成等长度的bytes类型。
ret = struct.pack('i', 18334)
print(ret, len(ret))

# 通过unpack反解回来 返回一个元组回来
ret1 = struct.unpack('i',ret)[0]
print(ret1)
Demo1
# 服务端代码(连续发送两次数据)
import socket
import struct

server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
server.bind(('0.0.0.0', 8888))
server.listen(5)

print("服务端已启动,等待客户端连接...")

conn, addr = server.accept()
print(f"客户端 {addr} 已连接")

try:
    data = b'Hello'
    header = struct.pack("!I", len(data))
    conn.send(header + data)  # 第一次发送
    data = b'World'
    header = struct.pack("!I", len(data))
    conn.send(header + data)  # 第二次发送
except KeyboardInterrupt:
    print("服务端主动终止")
finally:
    conn.close()
    server.close()

# 客户端代码
import socket
import struct

client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
client.connect(('127.0.0.1', 8888))

try:
    # 接收固定长度包头
    header = client.recv(4)
    data_size = struct.unpack("!I", header)[0]
    received_data = client.recv(data_size)
    print(f"实际接收长度: {len(received_data)} 字节")
    print(received_data)
except ConnectionResetError:
    print("服务端已关闭连接")
finally:
    client.close()
Demo2
# 服务端代码(发送 10KB 大数据包)
import socket
import struct

server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
server.bind(('0.0.0.0', 8888))
server.listen(5)

print("服务端已启动,等待客户端连接...")
conn, addr = server.accept()

try:
    # 发送 10KB 数据
    big_data = b'A' * 1024 * 10  # 10KB
    # 发送固定长度包头
    header = struct.pack("!I", len(big_data))
    conn.sendall(header + big_data)
    print(f"已发送 {len(big_data)} 字节数据")
except KeyboardInterrupt:
    print("服务端主动终止")
finally:
    conn.close()
    server.close()


#  客户端代码
import socket
import struct

client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
client.connect(('127.0.0.1', 8888))

try:
    # 接收固定长度包头
    header = client.recv(4)
    data_size = struct.unpack("!I", header)[0]
    # 接收完整数据
    received_data = b""
    while len(received_data) < data_size:
        remaining = data_size - len(received_data)
        chunk = client.recv(min(remaining, 1024))
        if not chunk:
            break
        received_data += chunk
    print(f"实际接收长度: {len(received_data)} 字节")

except ConnectionResetError:
    print("服务端已关闭连接")
finally:
    client.close()
HTTP协议
HTTP(HyperText Transfer Protocol,超文本传输协议)是用于在客户端(通常是浏览器)和服务器之间传输超文本(如HTML)的应用层协议.它是无状态的、面向请求-响应的协议,基于TCP/IP传输。
HTTP有不同版本号:
HTTP1.1:支持持久连接(长连接),一个 TCP 连接允许多个请求,新增 PUT、PATCH、DELETE 等HTTP2.0:性能大幅提升,新的二进制格式,多路复用,header 压缩,服务端推送
HTTP 工作原理
HTTP的工作过程可以总结为以下几个步骤:
- 建立连接: 客户端(如浏览器)与服务器之间通过TCP三次握手建立连接
- 发送请求: 客户端向服务器(Apache、
Nginx、IIS服务器)发送HTTP请求报文,请求资源或操作 - 服务器处理请求: HTTP服务器接收到请求后,处理请求并生成响应
- 返回响应: 服务器将响应报文返回给客户端
- 断开连接: 通常在响应完成后关闭TCP连接
URL 与 URI
URI(Uniform Resource Identifier)
URI 是统一资源标识符,用于标识互联网上的资源,URI 分为两种:
- URL(Uniform Resource
Locator): 统一资源定位符,用于描述资源的地址。 - URN(Uniform Resource Name): 统一资源名称,用于标识资源的名称,不依赖物理位置
URL(Uniform Resource Locator)
HTTP 使用统一资源标识符(Uniform Resource Identifiers, URI)来传输数据和建立连接。URL 是一种特殊类型的URI,包含了用于查找某个资源的足够的信息
URL 全称是 UniformResourceLocator, 中文叫统一资源定位符,是互联网上用来标识某一处资源的地址。以下面这个URL为例,介绍下普通URL的各部分组成:
http://iproute.cn:80/news/search?keyword=123&enc=utf8#name=321从上面的URL可以看出,一个完整的URL包括以下几部分:
- 协议部分: 该URL的协议部分为
http:,这代表网页使用的是HTTP 协议。在 Internet 中可以使用多种协议,如 HTTP,FTP 等等本例中使用的是 HTTP 协议。在http:后面的//为分隔符 - 域名(主机)部分: 该 URL 的域名部分为
iproute.cn。一个URL 中,也可以使用 IP 地址作为域名使用 - 端口部分: 跟在域名后面的是端口,域名和端口之间使用
:作为分隔符。端口不是一个 URL 必须的部分,如果省略端口部分,将采用默认端口 - 虚拟目录部分: 从域名后的第一个
/开始到最后一个/为止,是虚拟目录部分。虚拟目录也不是一个 URL 必须的部分。本例中的虚拟目录是/news/ - 文件名部分: 从域名后的最后一个
/开始到?为止,是文件名部分,如果没有?,则是从域名后的最后一个/开始到#为止,是文件部分,如果没有?和#,那么从域名后的最后一个/开始到结束,都是文件名部分。本例中的文件名是search。文件名部分也不是一个 URL 必须的部分,如果省略该部分,则使用默认的文件名 - 参数部分: 从
?开始到#为止之间的部分为参数部分,又称搜索部分、查询部分。本例中的参数部分为keyword=123&enc=utf8。参数可以允许有多个参数,参数与参数之间用&作为分隔符 - 锚部分: 从
#开始到最后,都是锚部分。本例中的锚部分是name。锚部分也不是一个 URL 必须的部分
HTTP 请求报文
客户端发送一个 HTTP 请求到服务器的请求消息包括以下格式:


==注意==:HTTP请求报文本质上就是一个符合HTTP协议规范的==’长字符串’==,所以我们应用层(用户层)的任务是:只需构造按照HTTP格式的纯字符串,剩下的TCPIP协议的封装与传输全部由操作系统内核自动完成
如何构造请求报文
通常有自己==手动拼接==和==使用库==两种方式
- 手动拼接:需要严格遵循HTTP报文的格式:
GET /user?name=Tom HTTP/1.1rn
Host: example.comrn
Connection: closern
rn- 使用编程语言的第三方库(Python的request库)
import requests
response = requests.get('http://example.com/user', params={'name': 'Tom'})
# 实际发送的字符串由 requests 库自动生成
POST 和 GET 请求方法区别
- 提交的过程
- GET 提交,请求的数据会附在URL之后(就是把数据放置在 HTTP 协议头中),以?分割URL和传输数据,多个参数用&连接
- POST 提交:把提交的数据放置在是HTTP包的包体中
- 传输数据的大小
- 首先声明:HTTP协议没有对传输的数据大小进行限制,HTTP 协议规范也没有对URL长度进行限制
- GET 提交,特定浏览器和服务器对URL长度有限制
- POST 提交,由于不是通过URL传值,理论上数据不受限
- 安全性
- POST 的安全性要比 GET 的安全性高
- 登录页面有可能被浏览器缓存,而缓存的是 URL
- 其他人查看浏览器的历史纪录,那么别人就可以拿到你的账号和密码
- 使用 GET 提交数据还可能会造成 Cross-site request forgery 攻击
HTTP 响应报文
服务的相应信息格式如下:


HTTP状态码
- 状态代码有三位数字组成,第一个数字定义了响应的类别,共分五种类别:
2xx:成功–表示请求已被成功接收、理解、接受4xx:客户端错误–请求有语法错误或请求无法实现5xx:服务器端错误–服务器未能实现合法的请求
- 常见状态码
200 OK                        //客户端请求成功
404 Not Found                 //请求资源不存在,eg:输入了错误的URL
500 Internal Server Error     //服务器发生不可预期的错误
HTTP请求方法
根据 HTTP 标准,HTTP 请求可以使用多种请求方法。
HTTP1.1 新增了五种请求方法:OPTIONS, PUT, DELETE, TRACE 和 CONNECT 方法。
- ==GET==:请求指定的页面信息,并返回实体主体。
- HEAD:类似于 get 请求,只不过返回的响应中没有具体的内容,用于获取报头
- ==POST==:向指定资源提交数据进行处理请求(例如提交表单或者上传文件)。数据被包含在请求体中。POST请求可能会导致新的资源的建立和/或已有资源的修改。
- PUT:从客户端向服务器传送的数据取代指定的文档的内容。
- DELETE:请求服务器删除指定的页面。
·CONNECT:HTTP/1.1协议中预留给能够将连接改为管道方式的代理服务器。- OPTIONS:允许客户端查看服务器的性能。
- TRACE:回显服务器收到的请求,主要用于测试或诊断。
长连接与短连接
HTTP1.1规定了默认保持长连接(HTTP persistent connection ,也有翻译为持久连接),数据传输完成了保持TCP连接不断开(不发RST包、不四次握手),等待在同域名下继续用这个通道传输数据;相反的就是短连接。
在实际使用中,HTTP 头部有了 Keep-Alive 这个值并不代表一定会使用长连接,客户端和服务器端都可以无视这个值,也就是不按标准来。毕竟 TCP 是一个双向连接的协议,双方都可以决定是不是主动断开。
客户端的长连接不可能无限期的拿着,会有一个超时时间,服务器有时候会告诉客户端超时时间。下图中的 Keep-Alive: timeout=20,表示这个TCP通道可以保持20秒
HTTP协议实践
Repable(Proxy):抓包工具
==本质==:Proxy是代理服务器的意思,可通过这个代理服务器抓包
抓包原理:请求发出去发给==代理服务器==,由==代理服务器软件==再发给百度,百度返回给软件,软件返回给浏览器,相当于==中间介入一个伪服务器==
Reqable在安装时主动把ssl根证书勾选就是可以主动把https里加密的s以明文的方式解析出来,如果没有就只像wireshark这种通过物理层的抓包,S解析不出来,必须主动添加密钥
百度浏览器抓包示例
先在浏览器里输入www.baidu.com发送HTTP请求报文


服务器返回响应并经浏览器渲染成百度页面


抓包原理


==总结==:响应体是数据,响应头是指令,浏览器按指令处理数据.
Deepseek请求报文
用编程的方式和Deepseek交流


==总结==:用Repable发送请求报文
- 需要在请求头中添加键值对,键为Authorization,值为Bearer Token(
api.keys),就可发送报文,==授权相关的字段==都放在请求头上 - URL和请求体. URL(含路径和查询参数):适合放==简短、非敏感的数据== ;请求体(Body):适合放较大、结构复杂、敏感的(
JSON对象,文件二进制流,可上传GB级文件)
Python创建请求报文

.jpeg)


.jpeg)

请求报文总结
对于服务端开发来说通过URL不同路径区分不同业务类型,得到不同功能数据
==本质==:对于不同接口文档,看接口文档授权参数是什么比如(Deepseek的是Authorization)然后后面是Token(API密钥)
http.client使用
URL中的中文编码

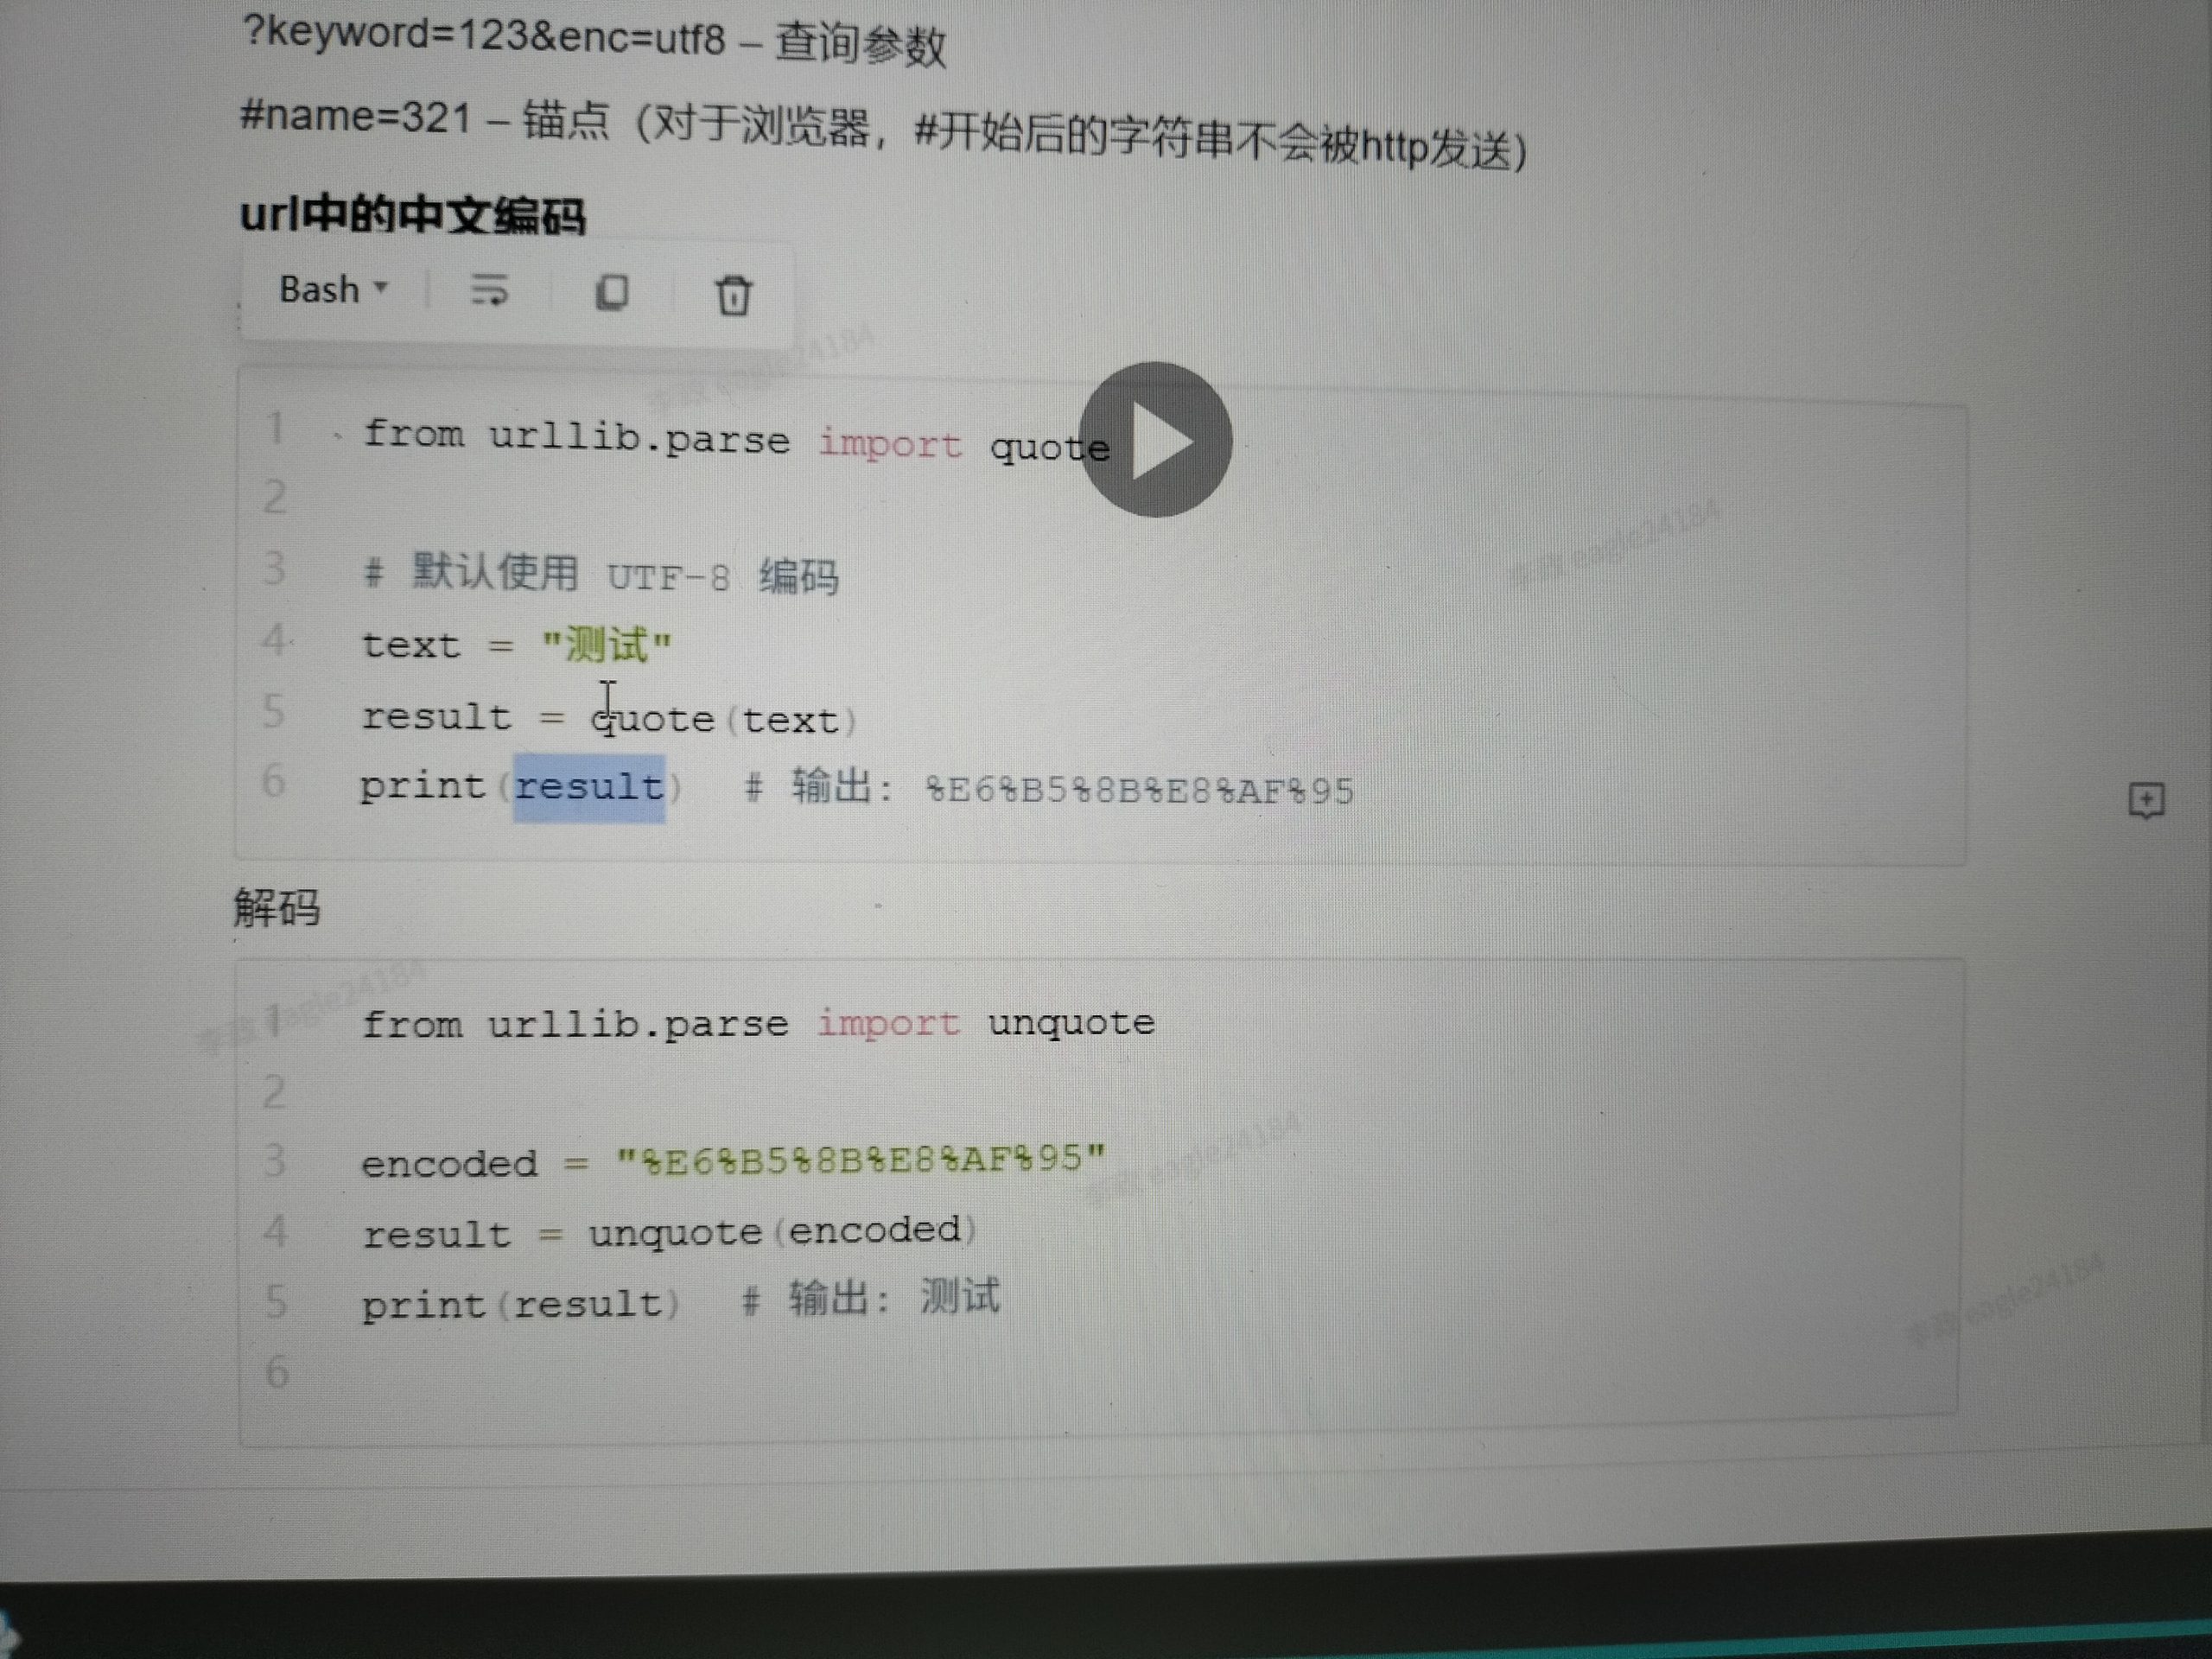


==注意==:URL不能直接传中文,必须将中文变成URL编码
开代理服务器:配合抓包服务器抓包


==抓包==:开代理服务器,配合抓包软件抓包
Body传输


==Body传输==:基本都是以json字符串形式
文件传输二进制
直接放进去


==注意==:文件要以二进制形式直接传进Body
Multipart格式
用虚拟环境装第三方包


Python第三方库(自动转为对应格式)


==总结==:改方法就改request后面函数名(get或post),改路径就改URL,改请求头就改headers后面的字典(授权,和token),改路径里的查询参数就改params后面,
要是想要请求体生成对应类型就直接打开文件或将任意数据写在开始构造请求体的response里用(json,data,或者打开文件或者file)自动转为对应请求体格式
==传输原理==: 普通参数(headers、params、data、json)基本都用字典(json也可以传列表)。
· 文件上传不能用 data 或 json,必须用 files 参数,并且传入的是文件对象(或者按规则构造的元组),而不是文件名字符串。
参数       常见类型                                         说明
headers   字典 {key:value,key:value}                       键值对,如 {'Authorization': 'Bearer token'}
params    字典 {key:value,key:value}                      URL查询参数,会自动拼接成  ?key=value
data      字典、元组,列表、字符串                            用于表单或普通文本
json      字典、列表 {key:value}                           自动序列化为JSON,并设置Content-Type: application/json
files     字典(值=文件对象/元组){file:f}    open ("filename") as  f
 用于上传文
(multipart/form-data)
一个示例


每个api接口文档
满足api接口文档要求就可以访问


API接口文档:开发者与服务的’沟通桥梁’,包含了构建和发送请求报文所需的一切信息
- 接口与地址:明确
API功能和URL - 请求方法:指定接口操作类型,如GET(获取)、POST(创建)等
- 认证方式:详细如何进行身份验证(例如,在请求头中加入Authorization : Bearer Token(你创建的
api—key) - 请求参数:提供详细的请求参数列表,包括名称、类型、是否必填等
- 请求与响应示例:提供完整、可直接参考的示例,直观展示请求和返回的数据格式
- 错误代码:列出不同错误及处理方法,方便快速排查
阅读文档的过程,就是帮助开发者系统化的构建出符合服务端要求的”请求报文”
Deepseek 大模型理解
根据接口文档的必要要求才可成功访问,所以本质是:==前端按照HTTP协议要求==成功发送请求报文到后端服务器,服务器根据已有的数据库的知识内容返回相应的响应体,这样就形成了人机交互
- 构建请求体:第一步对话的消息列表messages:教你设定模型的身份、角色、行为规则、回答风格,例如:”你是一个幽默的AI助手”
role:值固定为system,表示这条消息是”系统级的指令”,不是用户或助手发的普通消息,可以在system消息里的content里,自己设定符合你需求的角色(做一个智能助手、只坐翻译,只写代码,或者扮演某个角色)
-
"content":input("请输入你的请求:    "),
 "role": "user"
这是消息的用户指令,在运行时输入你想知道的数据知识或指令,角色定位为用户
- model:指定使用的是
Deepseek哪个模型来处理你的请求,thinking是思考模式:控制模型是否展示它的内部推理过程(像人一样”先想一想再回答”) ; enabled(开启),disabled(关闭) - reasoning_effort:控制模型在生成回答前进行”推理”的深度或强度,high是深度推理和运算;max_tokens取值一般为4096:模型生成的最大token数量(包括思考过程和最终长度),限制输出长度
- response_format:取值 type : text 指定模型返回结果的格式类型{ ‘text’ : 普通文本(默认). 模型输出纯文字,
"json_object": 强制模型输出合法的JSON对象},方便开发者直接解析结构化数据.你的场景只需普通文本,所以设为’text’. - stop : 指定一个或多个停止词[ ‘ nn ‘ ,’ 用户: ‘ ] 可防止模型继续生成对话,设置的 None 表示没有停止词,模型会一直生成直到max_tokens 限制或自然结束
- stream 取值 , False,作用:是否启用 ==流式输出==.
- False:模型一次性返回完整回答(等待全部生成后响应)
- True:模型以逐次/逐块返回,适合实时显示打字机效果
-
stream_options 取 None 作用:当 stream=True 时的额外选项,具体可设置作用(用到再说,可返回token使用统计). 你的设置 : None , 因为未启用流式 ,所以该选项无用
-
temperature: 取值为 1(范围通常 0~2,有时 0~1 ),作用:控制生成文本的随机性/创造性
- 值越低(如0.1):结果越确定、保守,适合事实性问答
- 值越高(如1.5):结果越多样、意外、适合创意写作
- 1 的话是默认平衡值,随机性适中.
- top_p是核采样中的一个参数,用于控制大语言模型生成文本时的随机性和多样性.
- 模型在生成下一个词时,会先列出所有可能词的概率
top_p:p=90%表示从概率最高开始累加,直到累加概率达到p为止,然后把那些累加达到概率要求的最高概率词,舍弃剩下的低概率词(10%),然后在这个新的词集中,按照概率词的权重来选
- tools :None或( 也可设为函数定义列表 ),作用:允许模型调用外部工具/函数(如查询数据库,调用
API). 需要提供工具的描述和参数schema. 表示不启用工具调用 - tool_choice : 取值”None”( 其他值 :”auto”、或指定工具名如{“type”:”function”,”function”:{ “name” :”my_tool”}}
作用:控制模型是否以及如何选择工具
- “none”: 强制模型不使用任何工具
- “auto”: 模型自行决定是否需要调度工具
你的设置:”none”,彻底禁用工具调用
logprobs:取值False,作用:是否返回输出token 的对数概率。
- True:每个生成token的对数概率会被返回(可用于计算置信度)
- 你的设置:False,不返回概率信息
top_logprobs: None 不返回 top 概率词- temperature和top_p都能控制生成文本的随机性/确定性,数值都调低时,两者都会让输出更稳定、更保守;temperature是整体调整概率分布的”曲线形状”,不会主动删掉低概率词,只是让他们更容易/更简单被抽到,top_p是动态地截断候选词表直接排除不符合的低概率词,然后对剩余词重新归一化.
==总结==:这些参数共同决定了模型的生成行为(随机性、停止条件、是否流式、是否输出概率,是否使用工具等).如果是标准的”普通对话”模式,无额外功能。
请求头:字典里包含HTTP请求头字段,用于向服务器传递请求的元信息
HTTP VS HTTPS
HTTP:明文传输,任何人通过Wireshark这个物理层抓包软件可直接看到原始请求报文
HTTPS=HTTP+TSL/SSL加密层:数据被加密成密文,只有客户端和服务器能用密钥解密,但是Reqable抓包软件可下载SSL根证书,所以可以根据SSL协议进行应用层抓包,会自动解析为明文
GET:只读请求,用于获取数据,规范要求它不能修改服务器资源(幂等且安全)
POST:提交数据,用于处理请求(比如创建,修改,删除),服务器根据你发送的Body数据做出相应的动作,并返回结果.
所以==敏感数据要用POST+HTTPS==,并且放在Body里